02|NaturalSpeech 2 与 3:连续扩散与语音属性分解
音频 token 的自回归建模不是唯一扩展路线。NaturalSpeech 2 在 codec 的连续潜空间使用扩散模型,NaturalSpeech 3 进一步把语音拆成内容、韵律、音色和声学细节,再分别组织生成条件。NaturalSpeech 2 · NaturalSpeech 3
分解表示的目的,是让不同生成任务面对更明确的条件和较小的变化范围。
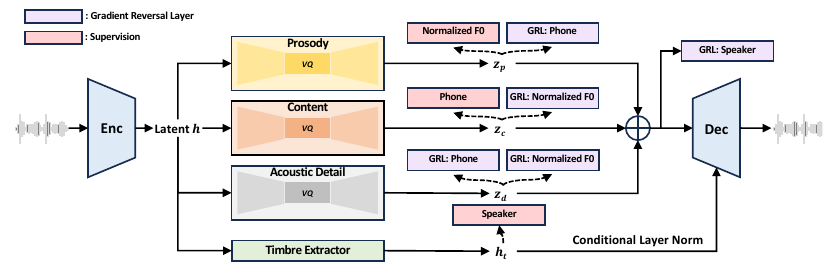
图 1|FACodec 将内容、韵律、细节与音色组织为不同路径
1. 两代方案的主要变化
| 项目 | NaturalSpeech 2 | NaturalSpeech 3 |
|---|---|---|
| 中间表示 | codec 连续潜变量 | FACodec 的属性子空间 |
| 生成组织 | 潜变量扩散,时长与 pitch 提供条件 | 时长、韵律、内容、细节的分解扩散 |
| 参考音频 | 提供提示条件 | 提取对应属性提示与音色条件 |
| 主要取舍 | 减少离散长序列逐 token 采样 | 提高模块可控性,同时增加分解训练复杂度 |
“分解”不是人工给每个维度指定一种属性。模型通过重建、属性预测、信息瓶颈及梯度反转等约束学习;仍可能有信息泄漏,因此需要交换属性的实验来检查效果。
2. 梯度反转为什么能减少信息泄漏
假设内容向量中不应轻易预测说话人。训练一个身份分类头,同时让编码器收到方向相反的梯度:分类头努力识别身份,编码器努力减少这类信息。以下是一般梯度反转教学式,用于解释论文中的解耦策略。
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 要约束的属性表示,如内容子空间向量。 | |
| 辅助属性预测损失,例如身份分类交叉熵。 | |
| 分类损失对表示的普通梯度。 | |
| 反转强度,非负超参数。 | |
| 反转层传回编码器的梯度;分类头自身仍按正常梯度训练。 | |
| 负号改变梯度方向,不代表前向向量变成负数。 |
若分类损失对二维表示的梯度为 (2,-1),强度为 0.5,反传给编码器的梯度是 (-1,0.5)。分类器变强与编码器抹除信息会互相博弈;强度过高可能损伤重建,不能把所有信息都无差别移除。
3. 属性交换应怎样验证
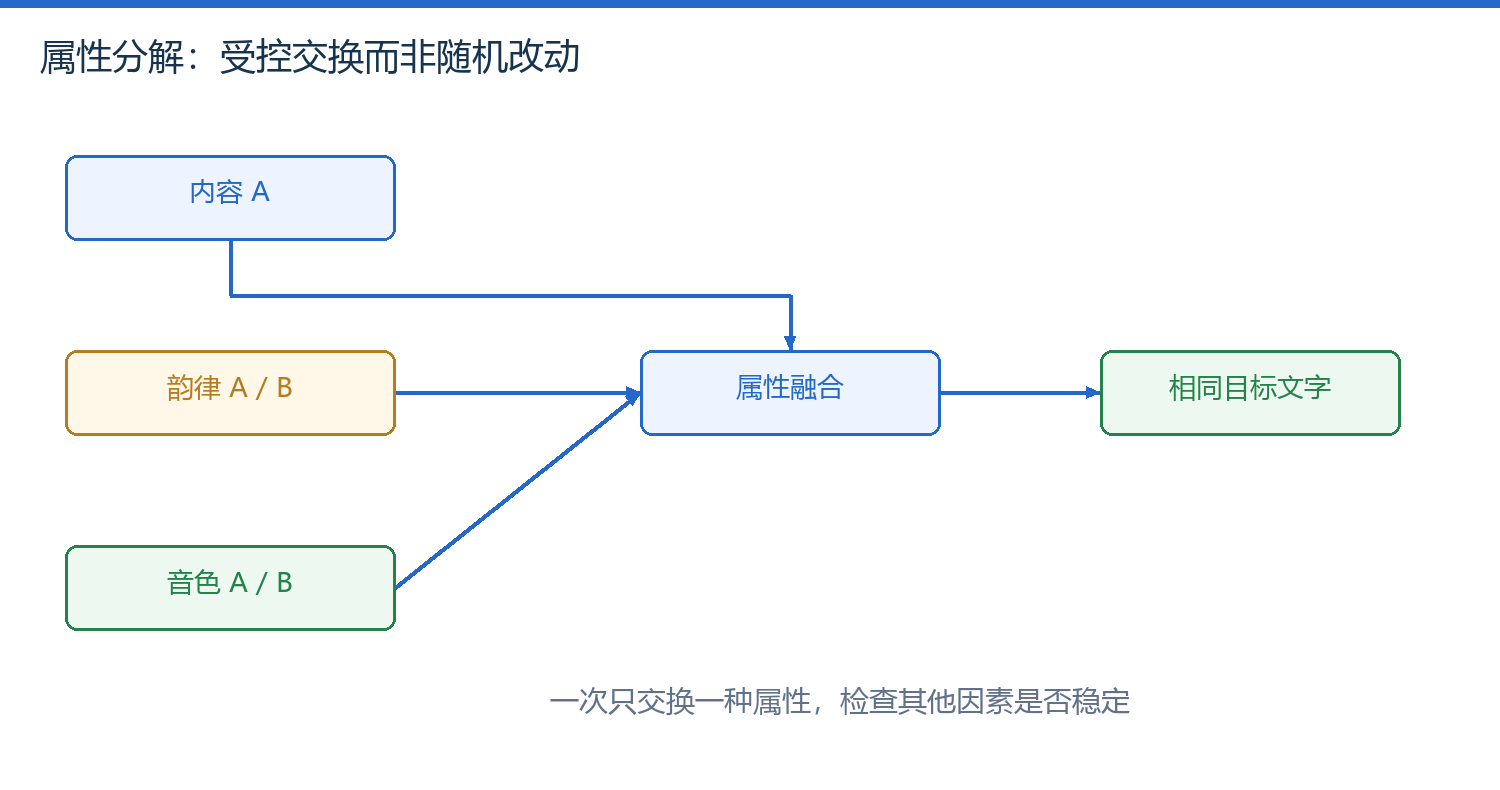
图 2|固定内容、交换音色与韵律的可控对照
| 实验 | 保持不变 | 交换因素 | 判断依据 |
|---|---|---|---|
| 音色交换 | 内容与韵律 | 说话人条件 | 文字、节奏稳定而声音身份改变 |
| 韵律交换 | 内容与音色 | 韵律条件 | 语调节奏变化且字词不变 |
| 去除细节支路 | 内容、韵律、音色 | 细节信息 | 检查细节恢复贡献与泄漏 |
可控性需要通过干预实验验证,不能只凭潜变量分了几路就宣布解耦成功。
扩散潜变量、离散码本和 mel 频谱是三种不同表示,不能套用同一 token 码率公式。
4. 与流匹配的联系
它们都通过多次网络评估把简单分布变成语音表示,但训练目标、噪声路径和采样器可能不同。下一章 F5-TTS从二维数值例出发解释速度场、ODE、条件掩码与推理成本,再连接 GPT-SoVITS v3/v4 的声学解码器。
正在连接 GitHub 评论…