12|2026 年 TTS 进展:多码本、离散扩散与严格流式
本章资料核对截止 2026-09-29。它记录可追溯的论文、官方仓库和发布信息,不宣称穷尽该日期之前的全部模型。过去的技术路线没有收敛成单一架构:自回归、多码本局部生成、连续流匹配与离散掩码生成都仍在发展。
当前变化集中在表示压缩、可控生成、长上下文和输入输出双向流式。
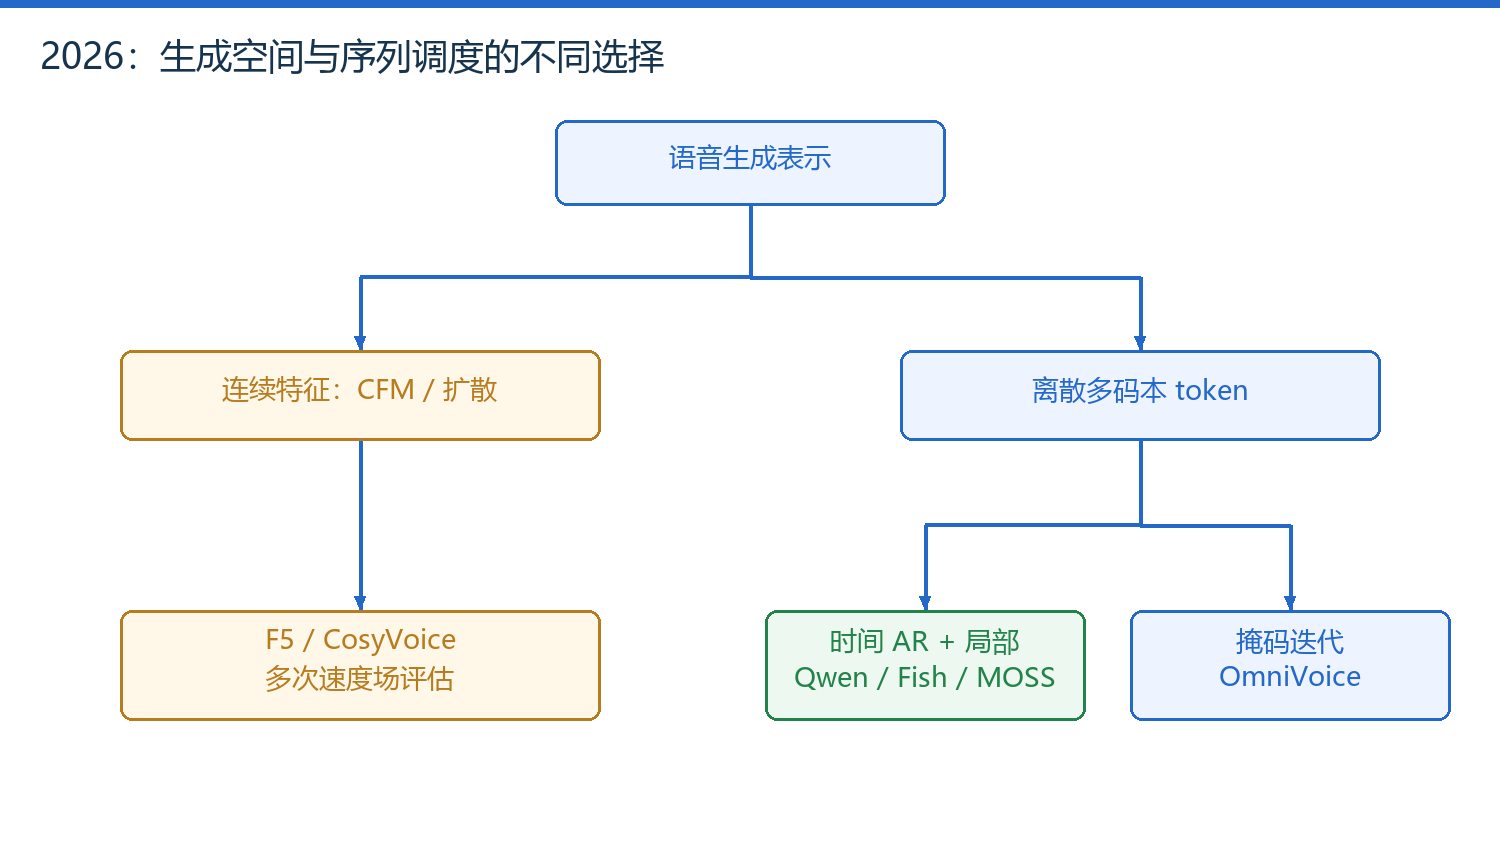
图 1|2026 年代表模型在生成空间与序列调度上的分布
1. 已核对的发布与研究节点
| 时间 / 状态 | 对象 | 变化 | 阅读入口 |
|---|---|---|---|
| 2026-01,已发布 | Qwen3-TTS 12Hz | 双轨输入、时间主干与帧内多码本生成 | 本专题 |
| 2026-03,论文与开放权重 | Fish Audio S2 Pro | Dual-AR、细粒度指令与多奖励后训练 | Fish 子文 |
| 2026-03 起,模型家族 | MOSS-TTS | Delay 与 Local Transformer 两条生成路线 | MOSS 子文 |
| 2026-04,论文与开放权重 | OmniVoice | 直接生成多码本 token 的离散掩码扩散 | OmniVoice 子文 |
| 2026-05/06,已更新 | MOSS v1.5 / tokenizer v2 | 语言标记、停顿控制、48 kHz 立体声等 | 官方仓库 |
| 2026-08,论文与实现 | X2Streaming-TTS | 未决文字缓冲与跨段语音状态继承 | 流式专题 |
MOSS 官方仓库中的 “2.0 coming soon” 是预告,本文不列为已发布权重。Fish S2.1 Pro 在官方服务资料中已出现,但不能从其 API 名称推断 S2 Pro 仓库就是同一权重。软件提交日期也不能替代模型发布日期。
2. 架构差异对应什么取舍
| 路线 | 长处 | 仍需解决 |
|---|---|---|
| 时间 AR + 局部码本 AR | 增量输出自然,降低大主干步数 | 帧内串行与长文本错误传播 |
| Delay pattern | 单一主干、多头结构规整 | 首尾延迟与码本错位协议 |
| 连续 CFM | 整段频谱联合建模、提示补全 | 多次网络评估、长度估计与分块连续性 |
| 离散掩码扩散 | 并行利用目标区双向上下文 | 迭代解掩码、长度预测与严格流式困难 |
更低 token 帧率减少时间步,却把更多信息压到每帧表示与解码器里。
3. “效果更好”需要拆成哪些指标
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 识别文本相对参考文本的替换词数。 | |
| 删除词数;这里不是音频时长。 | |
| 插入词数。 | |
| 参考文本词数。 | |
| 词错误率;中文也常使用按字计算的 CER,分词口径不可混用。 |
参考有 20 个词,替换 1、删除 1、插入 0,WER 为 10%。这个数字由合成内容和识别器共同影响;识别器把口音识别错也会增加分数,不能直接当作人类听错率。
| 维度 | 应记录 | 不应代替 |
|---|---|---|
| 内容正确性 | WER/CER、识别器、文本规范化规则 | 音质 |
| 身份相似 | 使用的 speaker encoder 与参考策略 | 风格可控性 |
| 自然度 | 盲听设计、样本量、置信区间 | 单条精选演示 |
| 指令遵循 | 成对输入、局部标签、独立判定 | 自动评分器自身偏好 |
| 延迟 | 首个可播音频、RTF、并发尾延迟 | 只给最快一次 |
不同数据集、ASR 与硬件上的排行榜数字不能直接拼成一张绝对优劣表。
4. 后续更新的核对顺序
先查官方模型卡是否新增权重,再查 release 与固定提交;从对应报告确认架构变化,最后复测同一组文本、参考与硬件。每次更新应记录“变更发生在哪个模块”,而不是仅把页面标题改为“最新”。本轮没有设置定时监控;本页是有明确日期的资料快照。
专题导航:TTS 总目录
正在连接 GitHub 评论…