03|联合训练、频谱后处理与波形重建
返回 Tacotron 总览 · 前一篇:注意力与多帧解码 · 下一篇:PyTorch 实现与验证
生成 mel 帧之后,系统还没有得到可以播放的波形。本篇把训练监督、线性频谱后处理、相位重建和结束行为串起来,明确每个环节究竟被什么信号约束。
1. 两项频谱损失与共享梯度路径
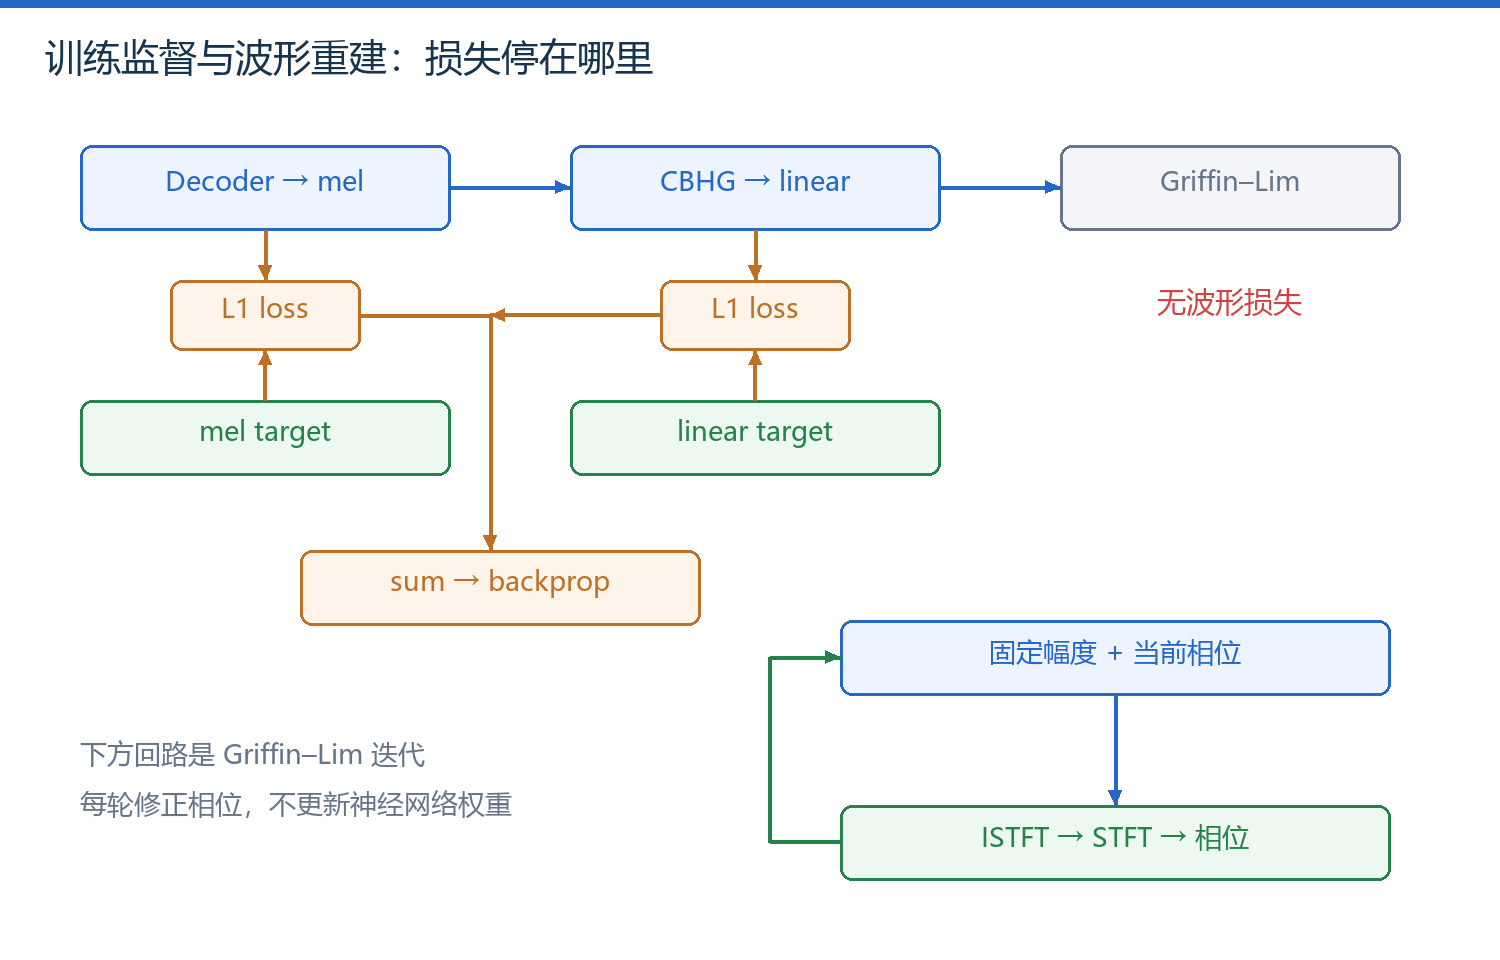
图 1|频谱监督与 Griffin–Lim 相位迭代的边界
训练数据是一条规范化文本和对应录音。录音经过同一套预处理得到 mel 与线性频谱两个目标;文本编码、注意力解码和后处理网络联合优化。原论文对两种频谱采用等权的 L1 损失。下面给出分别按元素取均值的明确实现形式;论文未规定所有底层归约细节,复现时应记录实际约定。
联合损失:目标、索引和归约
| 符号 | 含义、形状与约定 |
|---|---|
| 总损失;两项系数均为 1。 | |
| mel 预测的平均绝对误差。 | |
| 线性频谱预测的平均绝对误差。 | |
| 本计算约定中计入损失的帧数,包含采用的补齐区间。 | |
| mel 通道数,原版为 80。 | |
| 线性频率格数,原版为 1025;本页不把它用于卷积 bank 大小。 | |
| 帧索引,。 | |
| mel 通道索引,。 | |
| 线性频率格索引,。 | |
| 真实 mel 的 log 幅度目标;下标形式与单独的通道数 区分。 | |
| 解码器预测的对应值。 | |
| 真实线性频谱的 log 幅度目标;linear 指频率轴而非幅度未取对数。 | |
| 后处理网络的预测。 | |
| 绝对值,使正负误差不互相抵消。 | |
| 遍历所有指定帧与通道;批处理时还需对样本归约。 |
数值例:一个两帧、两通道的 mel 目标为 ,预测为 ,四个绝对误差为 0.2、0.3、0.2、0.1;相加 0.8,除以 4 得 0.2。若线性频谱平均误差为 0.3,总损失为 0.5。
| 监督项 | 直接约束 | 梯度还能流向 |
|---|---|---|
| mel 损失 | 解码器输出 | 注意力、文本编码器 |
| linear 损失 | 后处理输出 | 后处理、解码器、注意力、编码器 |
| 波形损失 | 原论文没有施加 | 不能声称以最终试听波形直接端到端反传 |
后处理输入必须是模型预测的 mel,才能让线性损失通过它约束上游网络。
若教学代码误把真实 mel 直接送进后处理网络,后处理虽能学到频谱映射,却不再对应上述联合预测路径。两项“等权”也依赖归约:把 1025 通道误差直接求和,与先各自取均值并非同一训练尺度。
2. 后处理网络的双向上下文
原版后处理也使用 CBHG,但卷积 bank 宽度上限为 8,输入是 80 通道 mel,两个卷积投影依次为 256 与 80 通道。后续 highway 为 128 维,双向 GRU 每方向 128 维,再投影到线性频谱。原论文表 1、§3.4
| 文本 CBHG | 频谱 CBHG | 差别为何重要 |
|---|---|---|
| 时间轴实际上是文本位置 | 时间轴是声学帧 | 相同层名不代表同一组参数或同一坐标 |
| 卷积 bank 上限 16 | 上限 8 | 提取的局部跨度不同 |
| 128 维残差输入 | 80 维残差输入 | 相加前必须匹配维度 |
| 用于注意力记忆 | 用于频谱细化与变换 | 后处理能查看已解码的前后帧 |
在实现 80 维残差输出到 128 维 highway 的连接时需要匹配维度,例如增加投影;表 1 并没有列出所有连接细节,应记录所采用的实现选择。不要把后处理 CBHG 当成“与编码器逐行复制即可”。
双向后处理需要整段或一定未来上下文;原版系统并非严格逐帧零等待的流式合成。
它有机会用相邻帧纠正局部频谱,仍不能保证修复上游已经漏掉的词。注意力读错内容与频谱不够精细是不同故障层级。
3. Griffin–Lim 如何补回相位
复频谱包含幅度与相位。模型预测幅度后,相位仍未知;任意选择相位再逆变换,得到的波形重新做 STFT 后,其幅度未必仍与目标一致。Griffin–Lim 在“指定幅度”和“能够对应某条时域波形的频谱”之间反复投影。
相位迭代:变量与操作
| 符号 | 含义、形状与约定 |
|---|---|
| 固定的非负幅度矩阵,形状为帧数 × 频率格数;下标 amp 表示 amplitude,已经撤销 log 与归一化。 | |
| 迭代轮次,非负整数;不是音频帧索引。 | |
| 第 轮的相位矩阵,与 同形状,单位弧度。 | |
| 虚数单位。 | |
| 单位模长的复数,携带相位。 | |
| 逐元素乘法,将每个频率格的幅度与相位结合。 | |
| 逆短时傅里叶变换,含窗口重叠相加等一致的合成约定。 | |
| 本轮时域波形估计。 | |
| 重新计算波形的复频谱;窗口、帧移和补齐约定必须一致。 | |
| 取复数辐角,保留新相位,下一轮仍使用固定幅度 。 |
单个频率格示例:目标幅度为 2,当前相位为 ,组合复数为 。假设经“逆变换—重新分析”后该格为 ,其相位为 、幅度约 1.414;下一轮保留新相位但恢复目标幅度,得到 。单格示例只解释替换规则;真实算法必须同时处理整张相互约束的时频矩阵。
| 步骤 | 需要统一的约定 | 常见错误 |
|---|---|---|
| 预测值转幅度 | 撤销训练时的 log、缩放与裁剪 | 直接将 log 频谱当非负幅度 |
| 相位迭代 | FFT、窗口、帧移、中心补齐、输出长度 | 分析和合成参数不一致 |
| 输出后处理 | 对应的反预加重与幅度控制 | 重复反归一化、直接裁剪爆音 |
原论文采用幅度的 1.2 次幂做经验处理,并使用 50 轮 Griffin–Lim;这些是原研究的实现选择,不能据此保证任意数据上同样最优。频谱误差小也不必然意味着听感自然。
4. 补齐、结束与故障定位
原版论文让模型也重建零补齐帧;不要直接替换成 Tacotron 2 的停止 token,再声称是原版。
原文观察到屏蔽全部补齐帧的损失可能导致末尾持续发声,因此让补齐区也参与重建。但论文并未给出适用于所有部署环境的唯一停止阈值。工程实现需要明确最长步数、静音或结束判定,不能把训练技巧当成完整终止协议。
| 可复现检查 | 观察什么 | 定位含义 |
|---|---|---|
| 真值频谱 → Griffin–Lim | 即使目标准确是否仍有金属感 | 检查重建器上限与参数 |
| teacher forcing 的 mel 与自由生成 mel 对比 | 误差是否随时间明显扩大 | 检查历史输入差异、索引和模型稳定性 |
| 同文本不同长度、标点版本 | 注意力何时停滞或跳跃 | 检查长句覆盖、规范化和对齐 |
| 频谱目标范围、静音帧值与 padding 值 | 三者是否相互矛盾 | “零补齐”必须在约定的特征空间解释 |
| 单句连续生成两次 | 状态是否清零 | 排除上一句隐藏状态污染 |
这些是真实训练后的排错路线,不是本专题已经执行的音质实验。下一篇只对能在 CPU 上快速核实的结构与索引给出实测证据。
正在连接 GitHub 评论…