01|WaveNet:原理、架构与实现
WaveNet 把声音生成写成一串“根据历史和条件,预测下一个采样点”的分类问题。这个专题面向学过神经网络、尚未接触 TTS 的读者:先理解声音如何变成标签,再走到网络结构、训练、缓存生成和实验验证。
阅读标记:关键概念 · 计算结果与正确关系 · 易错点与适用边界。
原论文网络架构
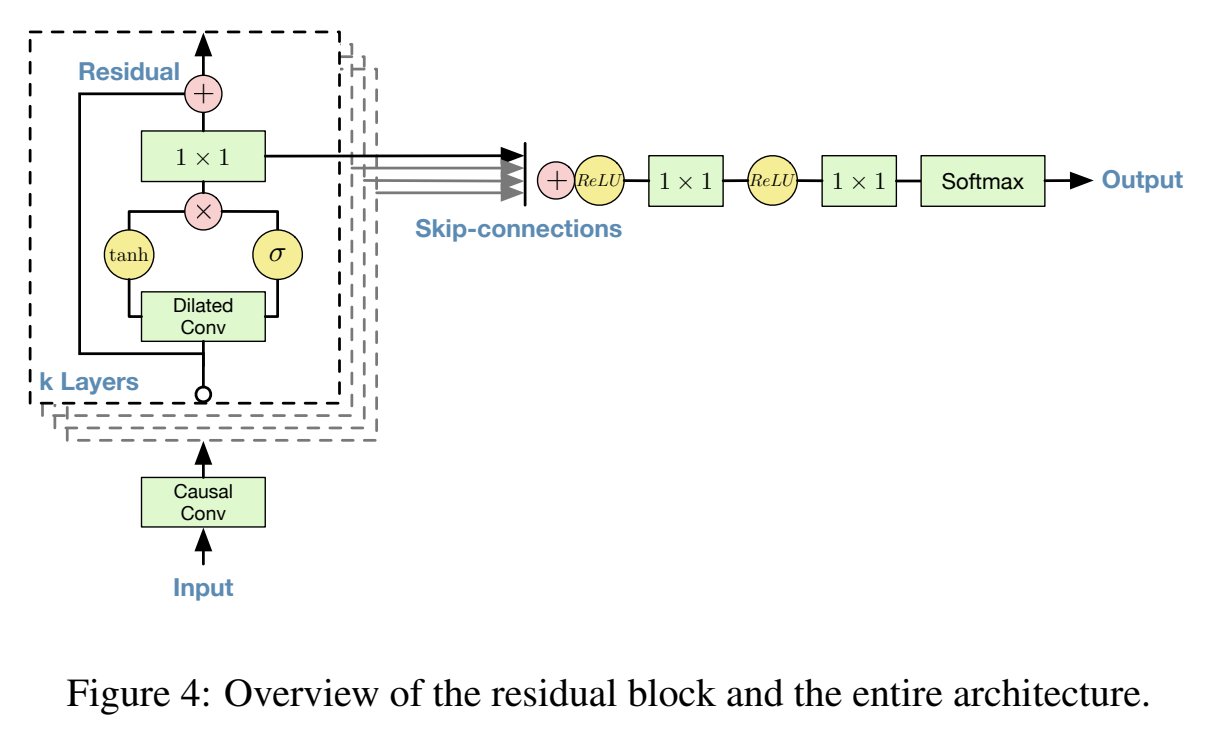
主干沿 Input 向上,skip 沿分支汇入右侧输出头。 对照原图读取三条计算路径:
| 图中位置 | 计算职责 | 读图重点 |
|---|---|---|
| 残差块堆叠 | 逐层处理历史采样 | 每层接收前一层的隐藏表示 |
| skip 分支汇合 | 汇集不同深度的特征 | 输出头读取所有 skip 的汇总 |
| Softmax | 给出下一采样点的类别分布 | 输出是概率,抽样后才得到一个类别 |
模型范围:WaveNet 波形模型不等于完整的文本转语音系统。 2016 年的 TTS 实验使用语言特征及基频等条件;条件通路定义在论文 §2.5,没有画在这张总图中。论文 §2.5、§3.2
本专题的“端到端”学习路线,是把输入、计算、输出和验证连成闭环;配套实验使用人工谐波,专门让波形模型内部可观察、可复核。
技术贡献与生成瓶颈
关键变化是直接学习波形的条件概率分布。 将模型所在的位置与常见表示区分开:
| 对象或路线 | 表示或处理什么 | 是否已能播放 |
|---|---|---|
| 音素 | 发音的基本单位 | 否,仍需时长与声学建模 |
| Mel 帧 | 短时频率能量在 Mel 频带上的表示 | 否,仍需波形生成 |
| 传统参数合成 | 预测音高、频谱等描述,再由声码器生成波形 | 最终波形可以播放 |
| WaveNet 波形模型 | 根据历史采样和条件预测下一点的分布 | 抽样并解码后得到波形 |
在 kHz 下,生成 秒音频需要 16000 次相互依赖的预测。两类加速改变的是不同环节:
| 加速方向 | 减少什么 | 是否仍逐点依赖 |
|---|---|---|
| 保存中间状态 | 已有历史的重复计算 | 是,下一点仍依赖上一点 |
| 改造生成方式 | 逐点串行的生成路径 | 取决于新模型的结构与训练方法 |
第 05 篇以缓存为例展开。训练能并行,不代表自由生成也能并行。
专题目录与阅读顺序
| 顺序 | 子文章 | 解决的问题 |
|---|---|---|
| 01 | 音频表示与概率建模 | 采样率、基频和 256 类标签分别是什么? |
| 02 | 因果卷积与感受野 | 怎样防止标签泄露,并计算可读的历史范围? |
| 03 | 门控残差与条件对齐 | 每个块如何计算,条件如何与目标对齐? |
| 04 | PyTorch 训练与生成 | 张量怎样流动,损失和采样循环怎样写? |
| 05 | 逐点生成缓存 | 缓存哪一层的什么状态,如何证明计算等价? |
| 06 | 实验复现与排错 | 怎样复现实验,哪些结论可以或不可以得出? |
| 附录 | 代码架构、运行入口与完整源码 | 先读架构图与接口表,再运行或查完整代码。 |
只有深度学习基础时,按 01 → 02 → 03 → 04 → 05 → 06 阅读。已经看懂概念、想知道代码怎样组织时,直接进入源码附录:先看架构图、接口表与执行路线,再按需查完整脚本。完整脚本留在参考页,不要求逐行通读后才能开始。
学习目标与实现范围
每篇都有可手算的小例子与检查题。读完后,应当能够解释:256 类从哪里来;为什么训练输入与标签差一格;12 层如何得到 127 点感受野;条件为何对齐目标;整段训练和逐点生成如何共享权重;缓存测试为何比较 logits。
| 对照项 | 原论文图或方法 | 本教程的实现选择 |
|---|---|---|
| 输入表示 | 总图入口为因果卷积 | 类别 embedding |
| 残差与 skip | 图 4 给出两路计算的基本骨架 | 两路单独建立 1×1 投影 |
| 条件与缩放 | 条件机制另见论文 §2.5 | 显式条件注入与残差缩放 |
| 实验规模 | 原论文的语音建模实验 | 24 隐藏通道、12 块、2 条件通道,57496 个参数 |
| 数据与证据 | 论文报告对应实验结果 | 四条人工谐波;实测与限制见第 06 篇 |
教学简化不应冒充原模型的固定配置。 本专题保留历史、条件、门控、残差、skip 和抽样的核心路径,用可复核的小实验说明它们如何配合。
正在连接 GitHub 评论…