03|训练目标:对抗损失、特征匹配与梯度路由
HiFi-GAN 训练中最容易写错的不是某个卷积核,而是两个优化阶段的计算图。判别器更新需要把假音频从生成器图中断开;生成器更新又必须让梯度穿过判别器回到假音频。两处写反,即使程序仍在运行,也可能根本没有训练到想训练的对象。
本篇将论文损失和一个可检查的标量计算图对应起来。原论文 §2.4 · 官方 train.py
冻结判别器参数,与禁止梯度经过判别器,是两件不同的事。
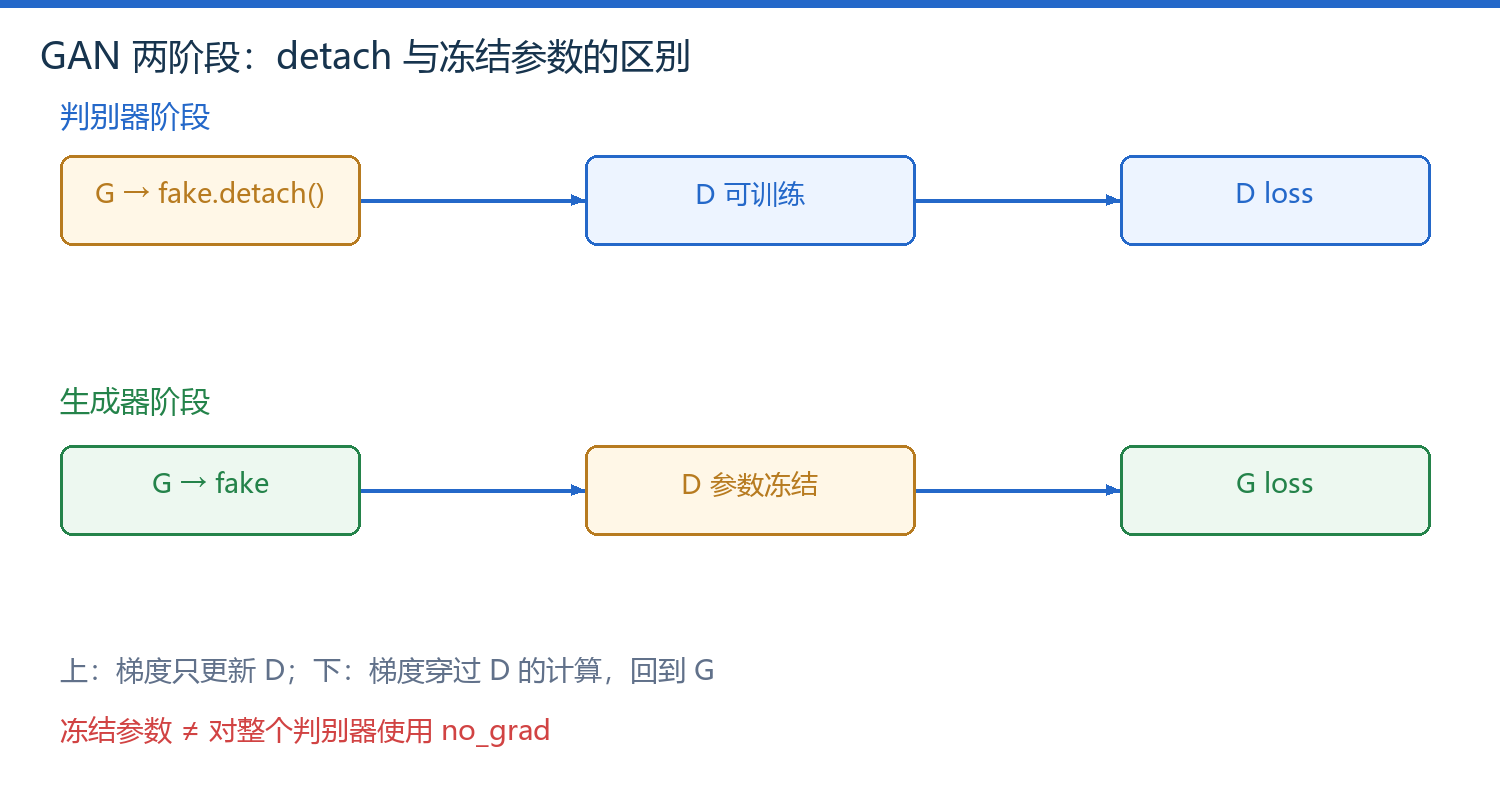
图 1|判别器与生成器两个阶段的梯度边界
1. 最小二乘对抗目标
先把某一子判别器简化为一个标量评分。真实目标为 1,生成目标对判别器为 0、对生成器为 1:
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 真实波形片段。 | |
| 与真实波形对齐的 mel 条件。 | |
| 生成器和当前判别器;真实训练对各子判别器评分取适当平均并汇总。 | |
| 假波形,须与真实片段长度匹配。 | |
| 更新判别器的目标;G 在此阶段不应收到梯度。 | |
| 更新生成器的对抗项;鼓励 D 给假波形高分。 |
若真实评分 0.8、假评分 0.3,判别器损失是 0.04+0.09=0.13,生成器对抗项为 0.49。这两个数不能相互比较大小来判断谁“赢了”;优化对象与目标不同,而且评分并不要求落在概率区间。
2. 内容约束与特征约束
仅让波形像真实语音,无法充分保证它对应给定 mel。特征匹配比较真实/生成波形经过判别器后的中间表示;mel 损失则直接比较两路声学变换。
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 生成波形 G(m)。 | |
| 子判别器与该判别器特征层的索引。 | |
| 该层中间特征,不是最终评分。 | |
| 与训练配置匹配的 mel 变换;包括幅度压缩等约定。 | |
| 逐元素绝对值与元素平均。 | |
| 原方法使用的特征匹配及 mel 项权重;归一化改变后不可盲抄。 | |
| 完整生成器目标的这一表示约定。 |
若三个未加权项分别为 0.49、0.10、0.02,总值为 0.49+0.20+0.90=1.59。mel 原值最小,加权贡献却最大。训练日志应同时保留原值和加权值,否则很难知道哪一路在主导更新。官方实现可能把系数 2 放入 feature loss 函数内部;外面再乘一次就会重复加权。
3. 两阶段更新的正确顺序
| 阶段 | 假波形是否 detach | 判别器参数 | 要保留的梯度路径 |
|---|---|---|---|
| 更新 D | 是 | 可训练 | 损失 → D |
| 更新 G | 否 | 可暂时冻结 | 损失 → D 的运算 → 假波形 → G |
更新 D 后应重新计算 G 阶段使用的判别器输出。若重复使用旧输出,它可能基于旧参数并携带已释放的计算图。D.requires_grad_(False) 不阻断输入梯度;with torch.no_grad(): D(fake) 会阻断,因此后者不能代替前者。
4. 标量实验与计算图验证
下面代码对应图 1 的两阶段路径,用两个标量代表网络参数,不执行优化器更新,目的是验证梯度去了哪里。完整语音 GAN 还需要批处理、真实网络、特征层与 mel 项。
def gan_gradient_check():
    # Scalar parameters expose the detach boundary exactly.
    g=torch.tensor(0.5,requires_grad=True)
    d=torch.tensor(0.4,requires_grad=True)
    real=torch.tensor(1.)
    fake=2*g
    loss_d=(d*real-1).square()+(d*fake.detach()).square()
    loss_d.backward()
    assert g.grad is None
    d_grad=float(d.grad)
    d.grad=None
    d.requires_grad_(False)
    loss_g=(d*fake-1).square()
    loss_g.backward()
    assert g.grad is not None and d.grad is None
    return dict(loss_d=float(loss_d.detach()),d_grad=d_grad,
                loss_g=float(loss_g.detach()),g_grad=float(g.grad))
实测 D 阶段 g.grad 为 None,D 梯度约为 −0.4;G 阶段 D 无新梯度,G 梯度约为 −0.96。只看损失值不能发现 detach 错误,直接检查梯度所有权更有针对性。
生成器阶段真实特征可当常量,假特征必须保留通往生成器的梯度。
5. 训练异常的逐层定位
| 现象 | 先核查 | 后做对照 |
|---|---|---|
| G 参数完全不变 | fake 是否 detach、是否 no_grad | 单步检查梯度范数 |
| 很快出现 NaN | mel 对数下界、输入幅值、学习率 | 定位第一处非有限张量 |
| 频谱正常但有细碎噪声 | 对抗项、周期判别器、数据质量 | 固定样本听测与谱对照 |
| 总 loss 降而内容漂移 | 各项权重、片段对齐 | 真实 mel 重建与预测 mel 分开测 |
这些小实验验证训练程序的机制,不证明已经训练出高质量 HiFi-GAN。
下一篇 前端接口与验证处理最常见的实际接入错误。
正在连接 GitHub 评论…