01|MOSS-TTS:延迟码本、局部 Transformer 与 v1.5
MOSS-TTS 报告在同一 tokenizer 基础上比较两种生成组织:单主干的延迟码本排列,以及全局时间建模加局部帧内 Transformer。两条路线提供不同的结构复杂度与生成效率取舍。技术报告 · 官方仓库
原版报告的 tokenizer 与 2026 年后续 tokenizer v2 必须分开描述。
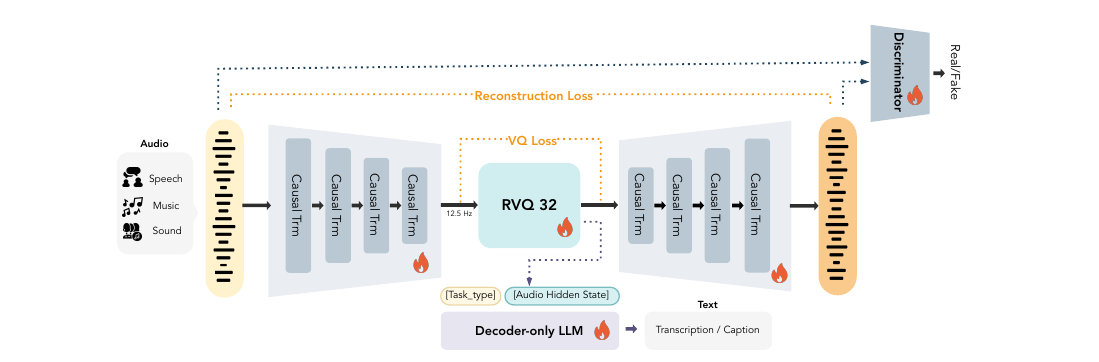
图 1|原版 MOSS-Audio-Tokenizer 的编码、RVQ、解码与联合监督
1. 原版报告的表示与生成器
| 部分 | 原版报告中的设计 | 阅读意义 |
|---|---|---|
| tokenizer | 24 kHz、12.5 fps、可变层数 RVQ | 高时间压缩与多层细节表达 |
| 语义学习 | 联合音频重建与语言相关任务 | 不完全依赖先训练好的外部语音教师 |
| Delay 模型 | 单主干、多输出头、码本错位 | 结构规整,方便扩展长上下文 |
| Local Transformer | 全局时间状态 + 帧内局部 AR | 大主干无需逐个声学码本运行 |
因果 tokenizer 每次只能利用允许的历史范围,否则即使语言模型逐帧生成,波形端仍可能等待未来上下文。所谓“低帧率”同时要求量化表示保留足够信息,不能只把高帧率特征机械抽稀。
2. 码本深度与名义码率
原版每层 1024 个码字,对 12.5 fps 的定长编码,每增加一层每秒增加 125 bit。32 层时为 4,000 bit/s。以下只是编号的名义码率,不含传输包头或压缩优化:
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 使用 K 个码本层时的名义码率,bit/s。 | |
| 本次使用的量化层数。 | |
| 原版 tokenizer 的帧率,帧/秒。 | |
| 1024 个码字对应 10 bit 编号。 |
| 量化层数 | 名义码率 | 要验证的问题 |
|---|---|---|
| 1 | 125 bit/s | 是否保留足够内容,音色细节损失多大 |
| 8 | 1,000 bit/s | 质量与 token 预测成本的平衡 |
| 32 | 4,000 bit/s | 细节收益能否覆盖额外计算 |
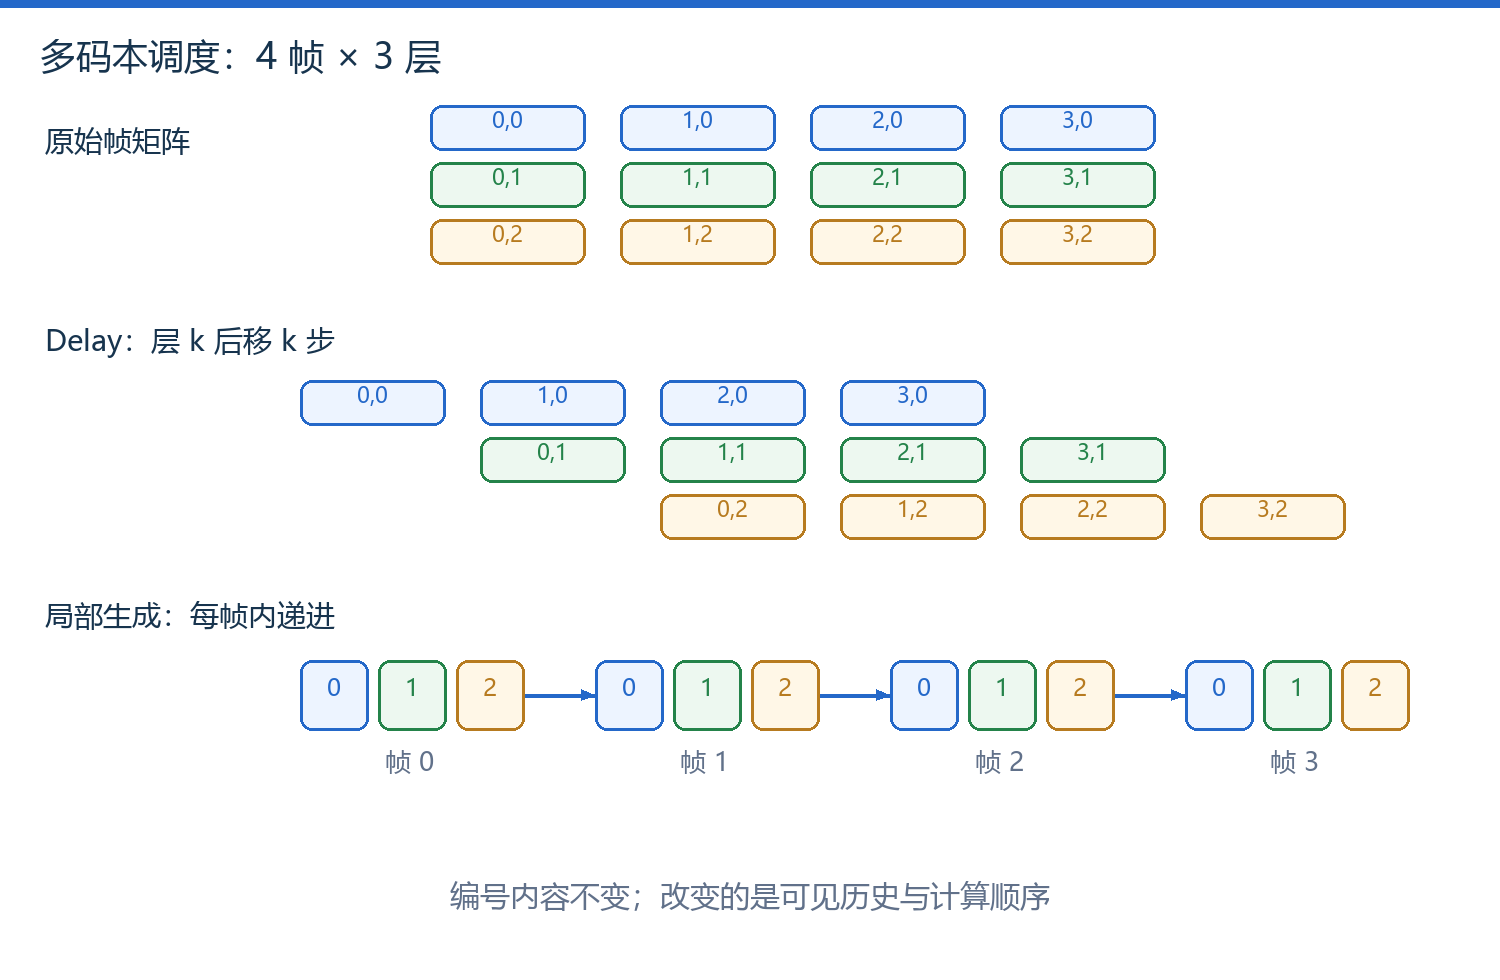
图 2|相同多码本表示可以采用延迟排列或局部预测
3. 截至 2026-09-29 的后续变化
| 官方日期 | 更新 | 不能混淆的内容 |
|---|---|---|
| 2026-05-26 | MOSS-TTS v1.5,语言标记、停顿指令等 | 继续训练更新,不等于另一个同名论文全部重写 |
| 2026-06-07 | MOSS-Audio-Tokenizer-v2,48 kHz 立体声 | 不能用原版 24 kHz 参数直接解释其全部结构 |
| 2026-06-18 | Local Transformer v1.5,4B 主干与 tokenizer v2 | 模型与 tokenizer 必须配套 |
| 官方页面仍为预告 | MOSS-TTS 2.0 | 不作为已下载、已验证模型 |
“高采样率”“立体声”“语言控制”分别改变输出格式与条件能力,不能只合并成音质更好四个字。
旧报告的 12.5 fps、32 层配置不能未经核对地移植到所有 v2 tokenizer 使用场景。
4. 实现与对照实验
官方仓库将 delay、local 与 local_v1.5 分目录组织。先检查消息序列和特殊标记,再看码本输出头与缓存;不要跨目录拼接不匹配的 processor、tokenizer 和 checkpoint。可以固定一段长文本,对比首个完整帧时间、说话人漂移与分段接缝;本页尚未执行大模型推理,未把作者报告写成本机性能。
正在连接 GitHub 评论…