02|因果卷积、膨胀卷积与感受野
这一篇回答两个问题:预测下一点时能读哪些输入;怎样在不降低时间分辨率的情况下看得更远。前提只是理解上一页的“振幅类别”。
最重要的约定: 输入 预测 。先把这个关系对齐,再检查卷积是否偷看未来。
1. 输入序列与预测目标对齐
网络位置 的输入是 ,标签是下一点 。 用序列 [12,18,25,20] 对齐三个预测任务:
| 网络位置 | 已知历史 | 当前输入 | 预测目标 |
|---|---|---|---|
[12] | |||
[12,18] | |||
[12,18,25] |
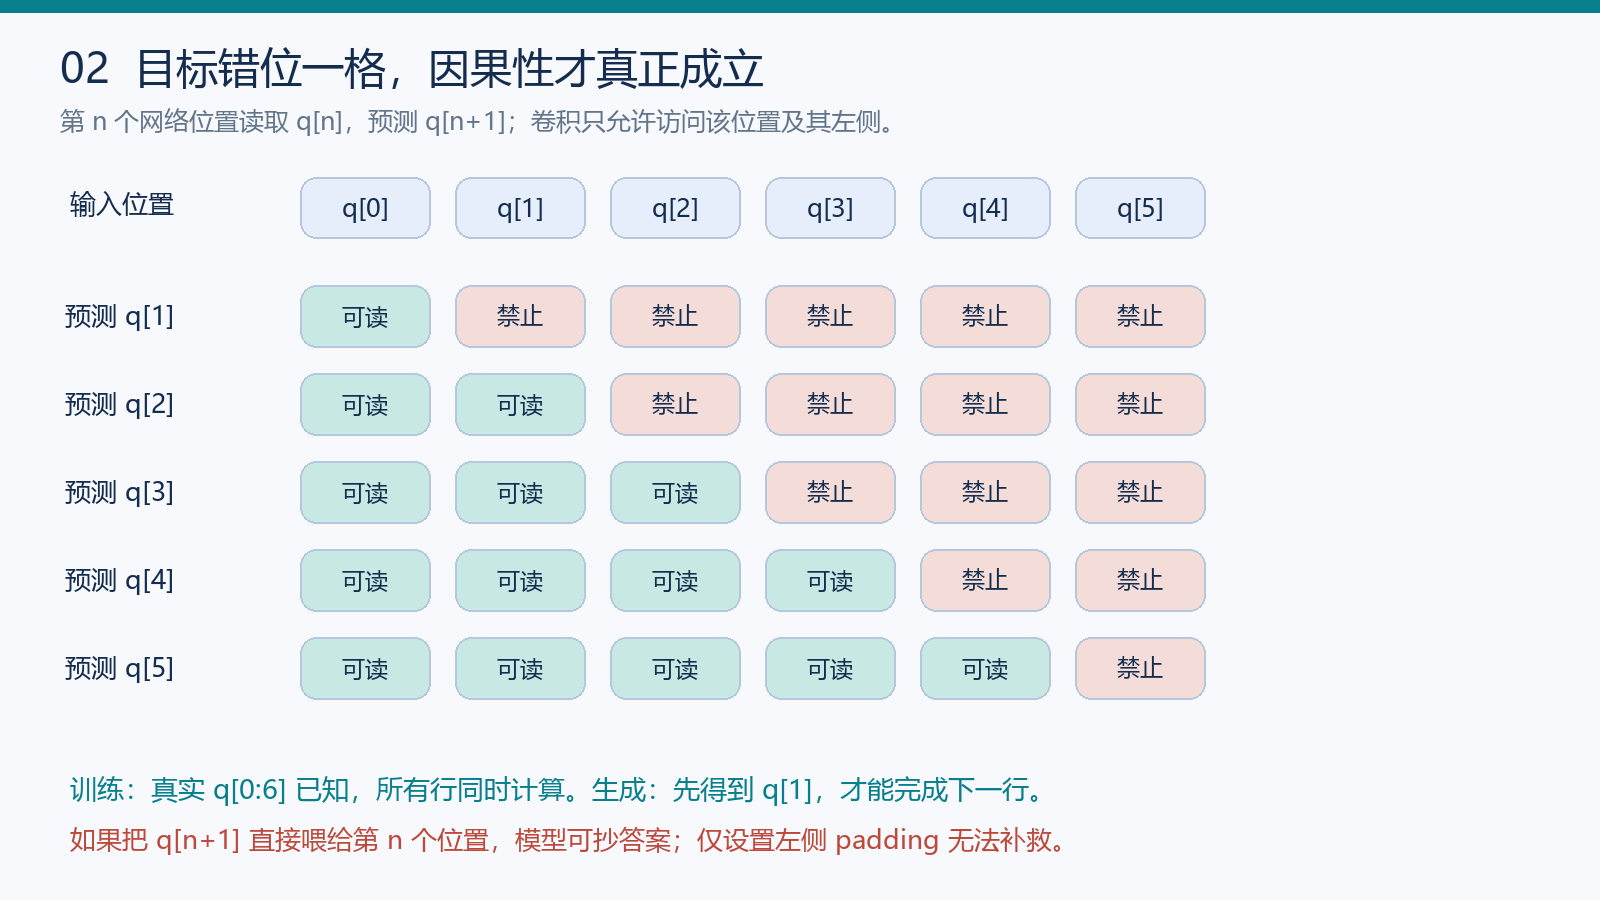
图 1|输入历史与下一点标签
逐行读图:绿色区域是允许读取的历史,红色区域含目标及其之后的波形。真正的有限感受野网络只能使用绿色区域的最近一部分。网络位置与波形目标索引差一格,后续所有公式和切片都沿用这个约定。
下面三行是数据语义约定,必须与模型一起检查。 为 [B,N],条件 cond 为 [B,H,N]; 是批大小、 是原始点数、 是条件通道数。输出长度 =−1。
inp = q[:, :-1]               # q[0]…q[N-2]
target = q[:, 1:]             # q[1]…q[N-1]
cond_target = cond[:, :, 1:]  # 与被预测的目标对齐
| 输入处理 | 对齐结果 | 判断 |
|---|---|---|
inp=q[:,:-1],target=q[:,1:] | 当前输入对应下一点标签 | 本教程约定 |
再把 inp 右移一格 | 额外丢掉最近一个已知点 | 不符合上述约定 |
| 直接用同一个 作为输入和标签 | 当前输入含有当前答案 | 标签泄露 |
2. 左侧填充与因果卷积计算
先抛开通道,只看时间索引。核宽 =2、膨胀率 =2 时,每个输出用到相隔两个索引的输入。 是核取样间距;它不会把输出点数减半。
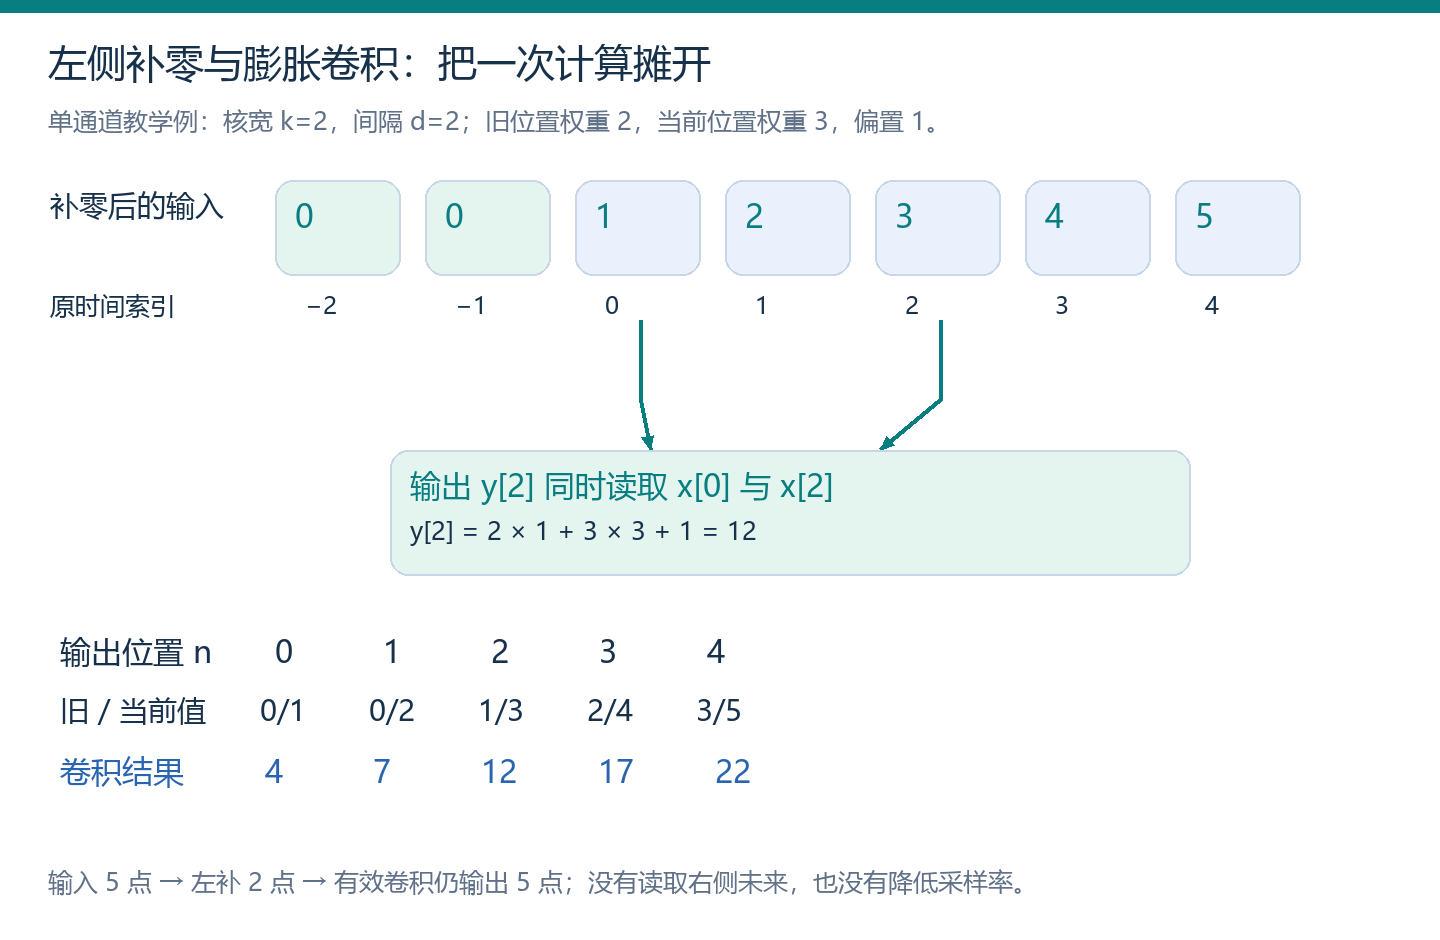
图 2|膨胀率为 2 的因果卷积
图的输入是 =[1,2,3,4,5],左侧补两个零。旧位置权重为 2、当前权重为 3、偏置为 1。通用的单通道表达式是:
因果卷积:符号与数值
| 数学记号 | 含义、单位与示例 |
|---|---|
| 输出时间索引,本例为 ;不是目标波形的索引。 | |
| 当前层在位置 的输入隐藏值;这里用单通道标量。 | |
| 当前层在位置 的卷积输出。 | |
| 膨胀率;本例为 。 | |
| 旧位置输入 的权重,本例为 。 | |
| 当前位置输入 的权重,本例为 。 | |
| 偏置,本例为 。越界输入采用隐藏零填充。 |
代入权重后,选取三个位置核对左边界与历史读取:
| 位置 | 旧位置输入 | 当前位置输入 | 卷积结果 |
|---|---|---|---|
| 越界,填 | |||
完整输出为 [4,7,12,17,22],可直接作为实现的检查样例。膨胀改变取样间距,不减少输出位置。
多通道时,把两个标量权重换成矩阵即可。若输入隐藏通道 =24,为同时准备门控两支,矩阵形状都是 [48,24],偏置有 48 个数;相应卷积核张量是 [48,24,2]。
实际代码先把 [B,C,T] 的输入左补 点,再做无额外 padding 的有效卷积。F.pad(x,(d,0)) 的两个数依次表示时间轴左侧与右侧;输出仍为 [B,2C,T]。
class CausalConv(nn.Module):
    def __init__(self, channels, dilation):
        super().__init__()
        self.dilation = dilation
        self.conv = nn.Conv1d(channels, 2 * channels, 2,
                              dilation=dilation)

    def forward(self, x):
        return self.conv(F.pad(x, (self.dilation, 0)))
一般核宽 、步长为 1 时,最远核位置距离当前 (k−1)d,所以左补同样多的位置可保长。这里 =2:补后长度 +,再被有效卷积扣掉 ,得到 。PyTorch 的 Conv1d 按互相关顺序应用权重,缓存实现必须保持旧→当前的核顺序。Conv1d 文档
3. 多层膨胀卷积的感受野
感受野是结构上可能影响一个输出的输入范围。 单层 只取两个位置;多层堆叠后,每个中间位置又读取自己的历史,因此要沿原图的连线逐层展开。
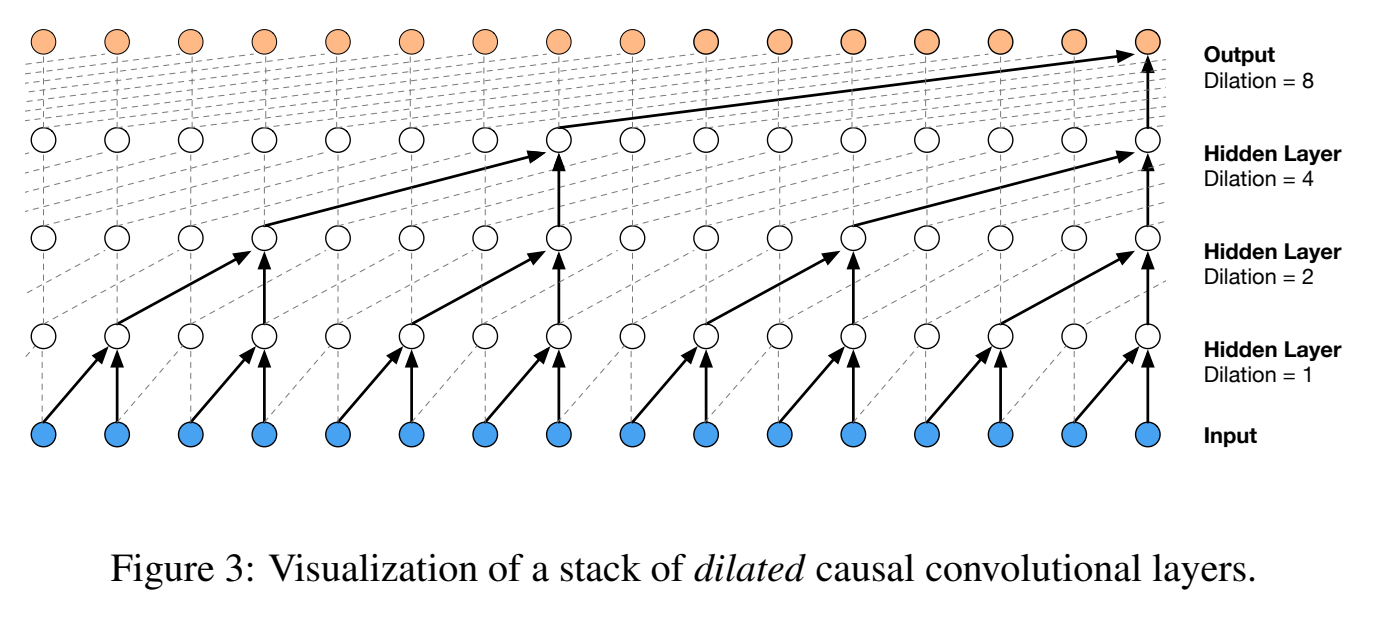
实线突出一条输出的依赖路径,虚线表示其余连接。 下表按输入到输出的顺序累计覆盖范围;各层核宽均为 :
| 已经过的层 | 本层膨胀率 | 新增最远距离(点) | 连续覆盖点数 |
|---|---|---|---|
| 输入 | — | — | |
| 第 1 层 | |||
| 第 2 层 | |||
| 第 3 层 | |||
| 第 4 层 |
从图顶端反向追踪时, 先把路径分成两支,后续 的连接填满中间位置。覆盖扩大,输出序列的长度仍然不变。
在所有层步长为 1、没有池化、额外输入层与输出头不跨时间的前提下:
感受野:符号与适用范围
| 数学记号 | 含义、单位与示例 |
|---|---|
| 按输入采样点计的感受野大小。 | |
| 卷积层数;原论文示意图取 。 | |
| 层索引,从 到 。 | |
| 第 层的卷积核宽度;本例各层为 。 | |
| 第 层的膨胀率。 | |
| 累加每层增加的最远历史距离。 | |
| 公式开头的常数项,计入当前位置的输入。 |
同一公式可以比较普通卷积、论文示意图和教学配置:
| 配置(核宽均为 ) | 膨胀率序列 | 感受野计算 |
|---|---|---|
| 四层普通卷积 | ||
| 论文图 3 | ||
| 本教程 12 层 | [1,2,4,8,16,32] 重复两轮 |
在教学配置中,输出位置 读取 ,预测 。输入窗口和目标仍然相差一个索引。
感受野换算成时间时,要区分“点数折算长度”和“首尾时间差”。下面固定 Hz:
| 比较量 | 计算 | 结果 |
|---|---|---|
| 127 个点折算的长度 | 秒 | ms |
| 首尾输入时间戳之差 | 秒 | ms |
| 125 Hz 信号的一个周期 | 秒 | ms |
本模型的窗口约覆盖两个周期,远短于一句语音。 长时内容需要上游条件等机制提供,不能靠这个小窗口凭空恢复。
最大跨度、实际可达位置和训练后的利用程度,是三个不同概念。
| 核宽为 的组合 | 相对当前输入的可达历史偏移 | 结论 |
|---|---|---|
| 两层 | 跨度为 7 点,中间有空洞 | |
| 三层 | 8 点连续覆盖 |
表中偏移 表示读取 。结构上可达,不保证训练后每一点都被有效利用。
4. 因果性的扰动验证
源码 verify() 用输入扰动检查因果性:
| 步骤 | 操作 | 预期结果 |
|---|---|---|
| 固定前缀 | 保持输入与条件的索引 不变 | 两次前向的已知历史相同 |
| 修改后缀 | 改动索引 及之后的数据 | 变化只发生在未来区域 |
| 比较输出 | 对比输出索引 | 前缀输出应保持不变 |
| 若检查失败 | 排查对称 padding、时间轴归一化等 | 找到未来信息混入的位置 |
因果性测试不能替代输入与标签的对齐检查。 把当前 错当标签时,网络仍可能通过结构上的因果性测试。
| 额外检查 | 应得到的结果 |
|---|---|
| 打印四点序列的输入与标签 | 与第 1 节的逐位置表一致 |
| 将膨胀率由 改为 | 核宽为 时,左 padding 也从 改为 ,保持长度与索引正确 |
正在连接 GitHub 评论…