05|CosyVoice 3:多任务表示、可微奖励与发音控制
CosyVoice 3 的变化不仅是增大数据。它增强语音 token 的多任务监督,并在生成阶段引入 DiffRO,让任务模型对生成 token 给出可微反馈;同时通过训练数据支持发音修补、文本规范化与细粒度指令。三类改动分别作用于表示、优化目标和输入控制。
本篇按原报告说明机制,具体模型权重和接口仍需结合配套实现。CosyVoice 3 §2
优化“能够被正确识别的语音 token”与直接优化所有听感维度,是不同的目标。
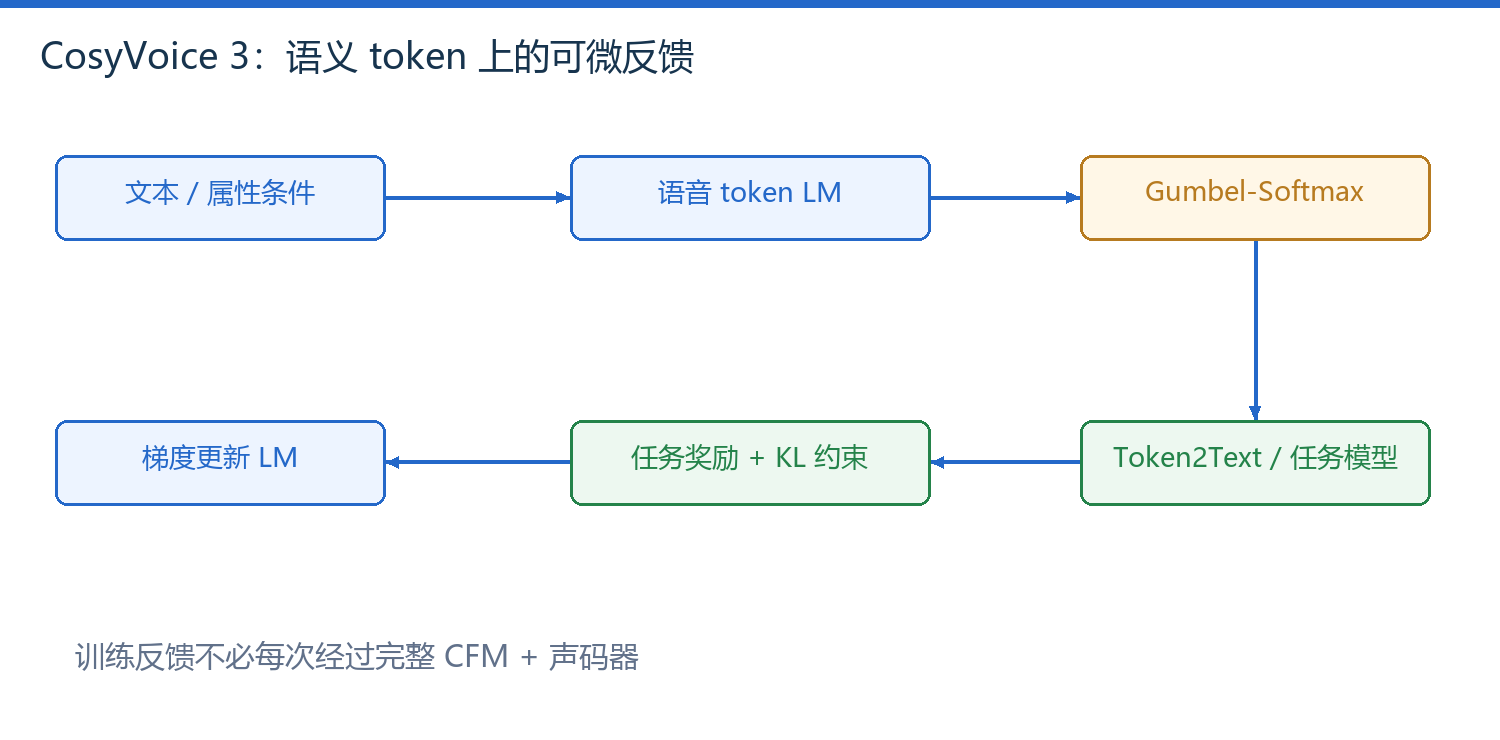
图 1|语义生成、软采样、任务奖励与 KL 约束的训练回路
1. 多任务编码监督与生成能力
只用 ASR 监督会偏重文字内容,多任务监督可进一步鼓励表示保留情绪、事件和其他声音属性。它改变的是 token 的信息分配:语言模型之后预测的目标,也随编码器表示而变。
| 训练任务 | 希望保留 | 可能的取舍 |
|---|---|---|
| 语音识别 | 发音与文字对应 | 对细微音色不一定敏感 |
| 情绪/声音事件 | 副语言和非语言线索 | 标签质量影响表示 |
| 声学解码相关训练 | 重建所需细节 | 更细 token 可能更难预测 |
这些监督不能保证属性完全解耦;同一 token 仍可能同时编码内容与风格。要验证可控性,需要固定内容只改一种条件。
2. 离散采样的梯度阻断与可微近似
普通采样把 logits 变成整数编号,后续任务分数无法通过这个整数操作直接向前传播。Gumbel-Softmax 用连续概率向量近似离散选择,让任务模型可以读取软嵌入。
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 离散词表编号;分母遍历同一词表。 | |
| 生成模型输出的未归一化 logit。 | |
| Gumbel 随机扰动,形成可微采样近似。 | |
| 正温度;小温度使概率更尖锐,也可能使优化更困难。 | |
| 连续软选择概率,和为 1。 | |
| 第 k 个 token 的嵌入和加权软嵌入。 |
取两类、logits (0,ln 3)、为说明计算临时令噪声为零、温度 1,软概率是 (0.25,0.75)。若嵌入为 (1,0) 和 (0,2),任务模型输入 (0.25,1.5)。真实训练会采噪声,这个零噪例只是手算 softmax,不代表完整 Gumbel 采样。
3. 奖励与参考模型约束
DiffRO 使用 Token2Text 等下游模型提供反馈,并以 KL 限制偏离参考生成器。用最小化记法可写为:
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 任务奖励;例如目标文字的识别后验相关得分。 | |
| 当前生成模型的 token 概率。 | |
| 固定参考模型的对应概率。 | |
| KL 权重,控制允许偏离参考模型的程度。 | |
| 教学版单位置目标;实际按时间、样本与任务约定汇总。 | |
| 自然对数;概率必须按稳定数值方式处理。 |
若当前分布 (0.75,0.25),参考 (0.5,0.5),KL 约为 0.75 ln 1.5+0.25 ln 0.5≈0.1308。β=0.1 时罚项约为 0.0131。奖励尺度若改变而 β 不变,约束的相对强度也会变化。
4. 奖励偏差与独立评测
| 奖励改善 | 仍需独立检查 |
|---|---|
| ASR 内容分数 | 自然度、身份相似和异常停顿 |
| 情绪分类分数 | 是否夸张失真、内容是否正确 |
| 自动 MOS 预测 | 评分器域偏差、真人盲听 |
原报告也讨论目标奖励与其他指标不完全同步的问题。后训练验证应保留没有参与奖励计算的指标和样本;否则可能只证明模型更适应自己的评分器。
KL 的作用是限制分布漂移,不是自动保证声音自然或身份保持。
5. 发音修补与指令的训练前提
CosyVoice 3 在训练中混合普通文字与音素/拼音,并扩展文本规范化及指令数据。输入控制因此有可学习的依据;未经训练的任意 XML 标签或英文命令并不自动生效。
| 控制目标 | 对照设计 | 判定 |
|---|---|---|
| 多音字修补 | 只改对应位置的发音输入 | 正确读音改善且其他文字不变 |
| 情绪控制 | 固定目标文字与参考身份 | 指令生效且可懂度不下降 |
| 原始数字读法 | 金额、日期、编号分别测 | 语境正确,不只逐字符读出 |
界面接受某个字符串,不等于模型训练过该控制格式;必须查配套示例与模型能力。
返回 CosyVoice 导读,结合 tokenizer、LM 和分块解码建立完整链路。
正在连接 GitHub 评论…