01|音频表示、μ-law 量化与概率建模
更新于 2026年10月1日 01:12:21MD公开
这一篇把声音变成你熟悉的张量与分类任务。读完应能回答:为什么一秒音频有成千上万个预测位置、256 类是怎样编码的,以及模型输出的“概率”究竟对应什么。
返回 WaveNet 导读 · 代码架构与完整源码
本篇主线: 声音是时间轴上的振幅序列;μ-law 改变振幅表示,WaveNet 预测下一类别的分布。
1. 离散波形与采样率
数字波形是一列按固定间隔记录的振幅。单声道、16 kHz、1 秒音频含 16000 个数;归一化振幅通常放在 −1 到 1。采样率是每秒记录多少点,基频是周期性信号每秒重复多少次。两者都用 Hz 表示,却不是同一个量。
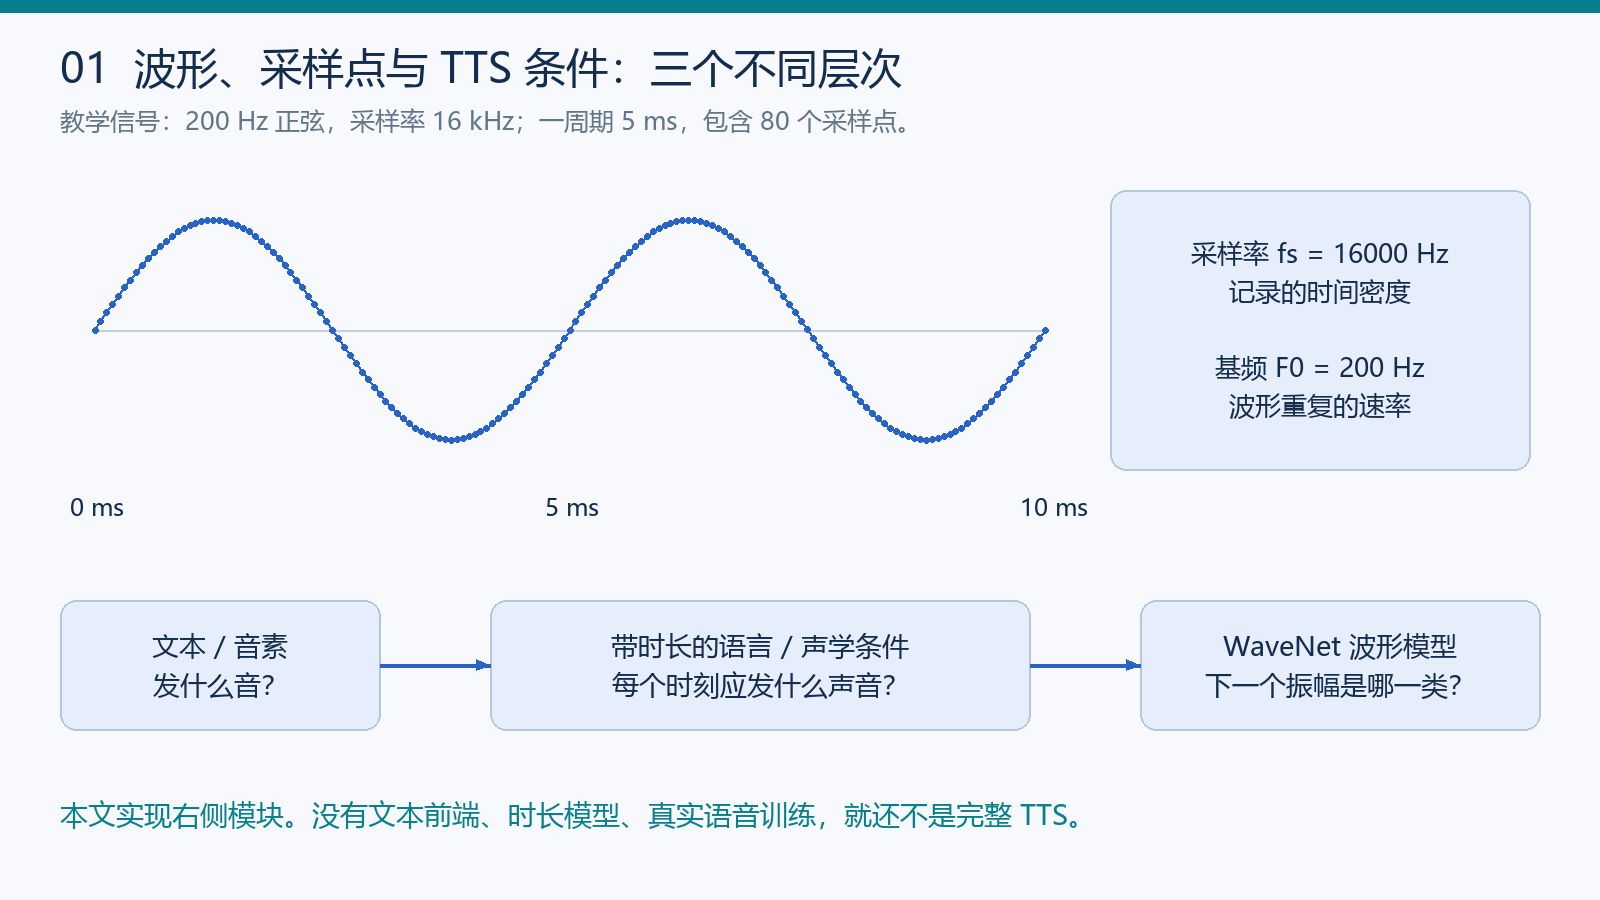
图 1|离散采样与波形模型的位置
先看上图的圆点:它们才是模型需要逐个生成的量。连线只是帮助观察形状。用一个简单正弦波把字母和数值对上:
x[n]=Asin(2πF0fsn+ϕ).
正弦波:符号与单位
| 数学记号 | 含义、单位与示例 |
|---|
| n | 采样索引,从 0 开始;n=20 是第 21 个点。 |
| x[n] | 索引 n 处的归一化振幅,无量纲,范围为 [−A,A]。 |
| A | 振幅系数,无量纲;本例为 0.8。 |
| fs | 采样率,单位为点/秒(Hz);本例为 16000。 |
| F0 | 基频,单位为周期/秒(Hz);本例为 200。 |
| ϕ | 初相位,单位为弧度;本例为 0。 |
| π | 圆周率;2π 弧度对应一周。 |
| sin | 正弦函数,将相位映射为 [−1,1] 内的值。 |
代入 n=20,按“时间 → 相位 → 振幅”计算:
| 步骤 | 代入与结果 | 含义 |
|---|
| 采样时刻 | 20/16000=0.00125 秒 | 第 21 个点对应的时间 |
| 相位 | 2π×200×0.00125=π/2 | 四分之一个周期 |
| 振幅 | x[20]=0.8sin(π/2)=0.8 | 正弦波到达正峰值 |
| 周期 | 1/200=0.005 秒 | 即 5 ms |
| 每周期点数 | 16000/200=80 | 时间被离散为 80 个位置 |
正弦波只用于解释采样。 真实语音还含谐波、噪声与随时间变化的包络。
2. μ-law 压扩与振幅量化
PCM 常用整数保存振幅。直接把 16 位数值当类别会有 65536 类。经典 WaveNet 方案先做 μ-law 非线性变换,再量化为 256 类;这是一种振幅表示选择。原论文 §2.2
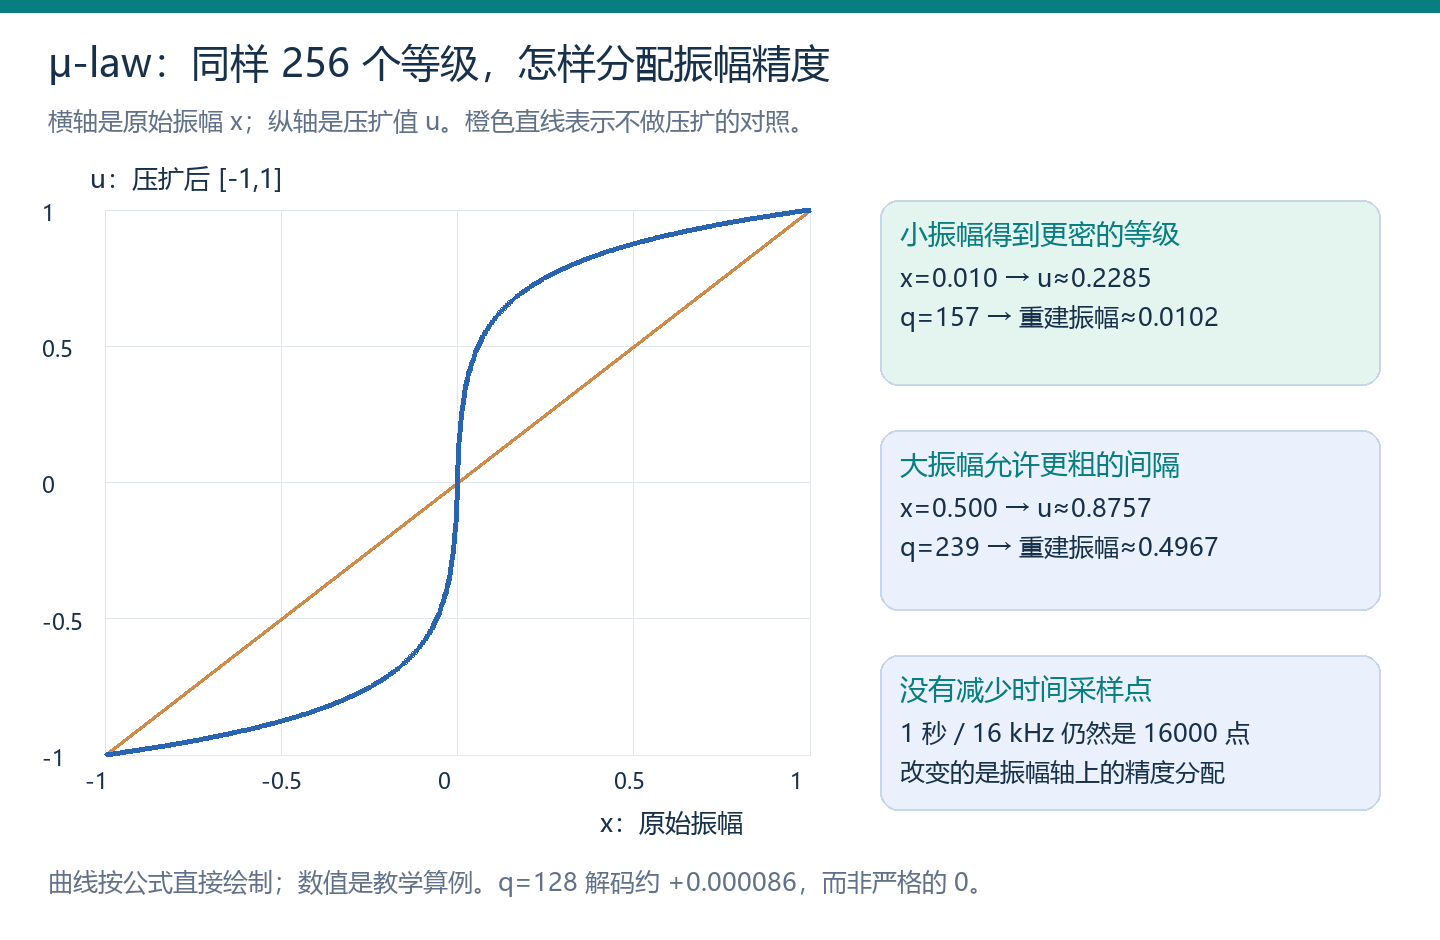
图 2|μ-law 压扩曲线与量化示例
μ-law 把更多量化等级分配给小振幅区域。 对照图中的曲线斜率:
| 原振幅区域 | 压扩曲线 | 在原振幅轴上的量化间隔 |
|---|
| 零附近 | 更陡,相近输入被拉开 | 更密 |
| 靠近 ±1 | 更平缓 | 更粗 |
量化格子在压扩后的纵轴上均匀划分,经过反变换后才得到上述不同间隔。
u=sign(x)ln(1+μ)ln(1+μ∣x∣),q=round(2u+1μ).
μ-law 编码:符号与运算
| 数学记号 | 含义、单位与示例 |
|---|
| x | 归一化输入振幅,先限制到 [−1,1];这里省略时间下标。 |
| μ | 压扩参数,本实现固定为 255。 |
| Q | 类别总数,Q=μ+1=256。 |
| u | 压扩后的连续值,仍在 [−1,1] 内。 |
| q | 量化后的整数类别,取值为 0,…,255;不能直接当作线性振幅。 |
| sign | 符号函数,区分正、零、负输入。 |
| ∣x∣ | 绝对值,取输入振幅的大小。 |
| ln | 自然对数。 |
| round | 舍入到最近整数;代码采用 PyTorch 的 round 规则。 |
例如 x=0.5:u=ln(128.5)/ln(256)≈0.87570,再算 (u+1)×255/2≈239.151,舍入得到 q=239。若 x=0.01,则 u≈0.22848、q=157。这些运算逐点进行,张量的时间长度完全不变。
解码时,先把类别拉回压扩空间,再反变换:
u^=2q/255−1,x^=sign(u^)255256∣u^∣−1.
μ-law 解码:符号与数值示例
| 数学记号 | 含义、单位与示例 |
|---|
| u^ | 由整数类别重建的压扩值;帽号表示重建量。 |
| x^ | 解码得到的归一化振幅。 |
| q | 已保存的量化类别;本例取 239。 |
| 255 | 压扩参数 μ。 |
| 256 | 类别数 μ+1。 |
取 q=239,有 u^=223/255≈0.87451、x^≈0.49668,与原振幅 0.5 相差约 −0.00332。量化后通常不能无损恢复。
下面代码仅实现上面的编码过程。输入是浮点波形,输出是相同形状的 long 类别;变量 y 对应公式中的 u。log1p(v) 计算 ln(1+v),用于小数值时更稳健。
def mu_encode(x, mu=255):
    x = x.clamp(-1, 1)
    y = x.sign() * torch.log1p(mu * x.abs()) / math.log1p(mu)
    return ((y + 1) * mu / 2).round().long()
| 输入振幅 | 编码类别 | 解码或使用时的含义 |
|---|
| −1 | 0 | 最负振幅,不是静音 |
| 0 | 128 | 解码约为 +0.000086,并非精确的零 |
| +1 | 255 | 最正振幅 |
256 个等级是偶数,中心没有恰好落在零上的等级。卷积的左侧零填充发生在隐藏空间,不能用波形类别 0 替代。
3. 自回归概率分解与分类目标
量化后的序列记为 q0,…,qt。对 N 个点、已知条件 c,概率链式法则给出:
p(q0,…,qN−1∣c)=p(q0∣c)t=1∏N−1p(qt∣q0,…,qt−1,c).
概率链式分解:符号与索引
| 数学记号 | 含义、单位与示例 |
|---|
| p | 离散变量的概率或条件概率。 |
| N | 原始序列的点数;下面的示例取 N=3。 |
| t | 当前目标的索引,从 1 到 N−1。 |
| qt | 索引 t 处的量化类别。 |
| c | 给定的条件序列。 |
| ∣ | 条件分隔符,表示右侧的信息已知。 |
| ∏t=1N−1 | 把各步条件概率相乘。 |
这是概率恒等式,尚未规定卷积结构。实际网络只读取最近有限的历史,属于建模近似。
取 N=3,种子 q0 已给定。如果 p(q1=18∣q0,c)=0.2,接着 p(q2=25∣q0,q1=18,c)=0.3,那么这段延续 [18,25] 的条件概率为 0.2×0.3=0.06。本脚本给定第一个种子,学习后面的条件概率,没有训练 q0 的先验。
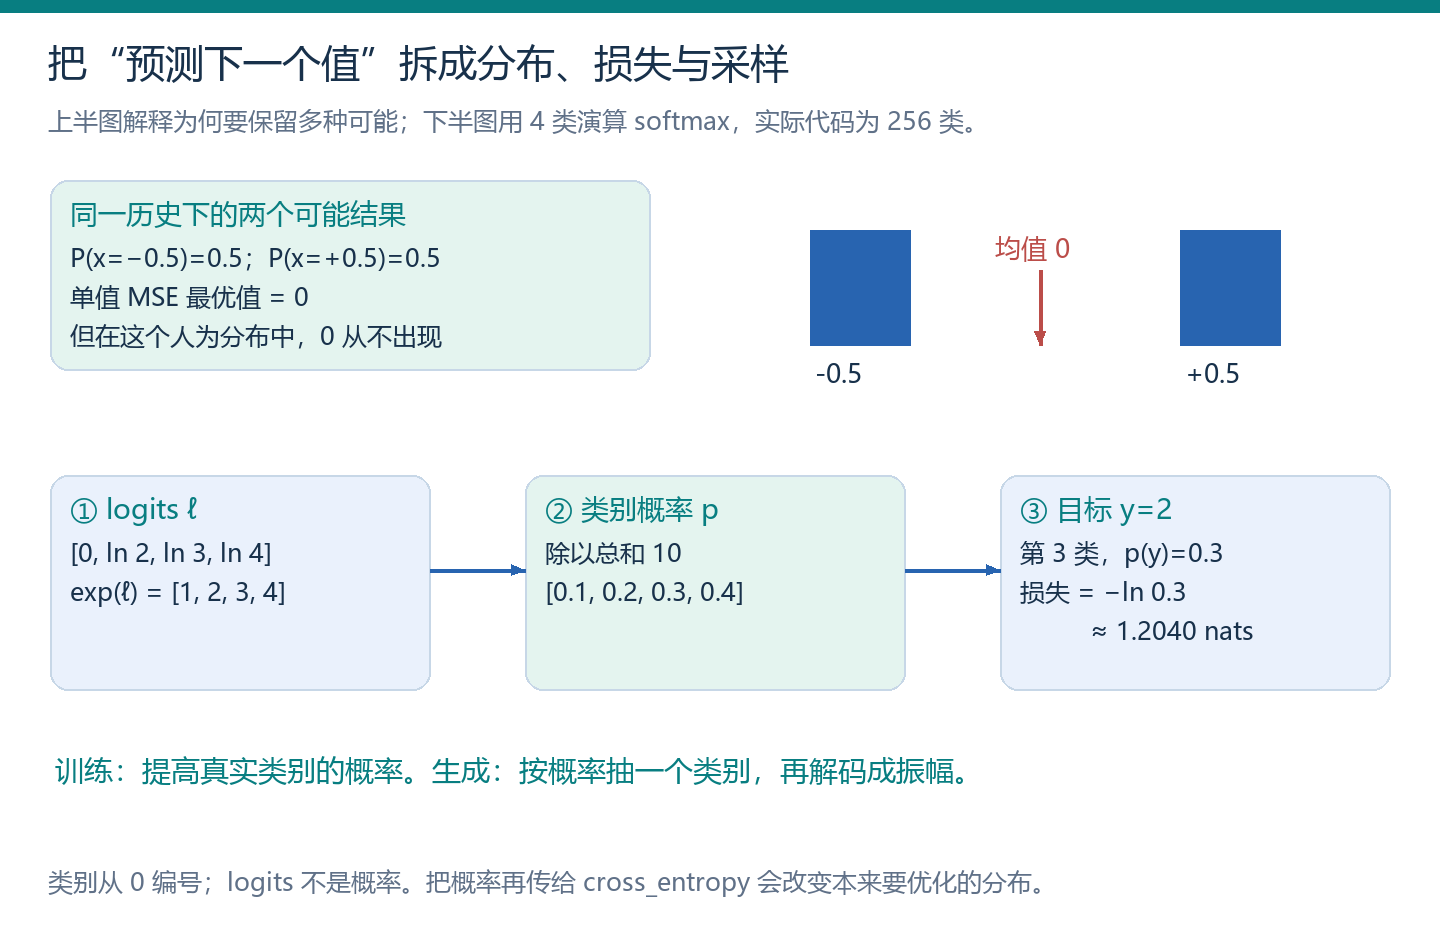
图 3|分布预测与四类别 Softmax
上半图是一个人为反例:下一个振幅只可能是 ±0.5,各占一半。单值均方误差的最优答案是平均数 0,却不是这个分布中可能发生的结果。分布预测能保留多种可能,再抽出一个;这个例子不意味着所有回归模型都会失败。
下半图对应实际模型的最后一步。网络给每个类别一个未归一化分数 logit,记为 ℓj:
pj=∑k=0Q−1exp(ℓk)exp(ℓj),Lt=−lnpyt.
Softmax 与交叉熵:逐项符号说明
| 数学记号 | 含义、单位与示例 |
|---|
| Q | 类别总数;实际模型取 Q=256,下方手算示例取 Q=4。 |
| j | 要查询的类别编号,0≤j<Q。 |
| k | 分母中遍历所有类别的求和索引。 |
| ℓj | 网络对类别 j 给出的未归一化分数(logit),不是概率。 |
| exp | 指数函数;exp(v)=ev,其中 e 是自然常数,v 是输入标量。 |
| pj | 归一化后的类别概率;所有类别概率之和为 1。 |
| t | 当前预测目标的时间索引。 |
| yt | 时刻 t 的真实类别编号。 |
| pyt | 从预测分布中取出真实类别对应的概率。 |
| Lt | 该目标的负对数似然损失;使用自然对数时,单位为 nats。 |
| ln | 自然对数;正确类别的概率越高,损失越小。 |
图中临时使用 Q=4。从分数到概率,每一步都可直接核对:
| 类别 j | 分数 ℓj | 指数 exp(ℓj) | 概率 pj |
|---|
| 0 | 0 | 1 | 0.1 |
| 1 | ln2 | 2 | 0.2 |
| 2 | ln3 | 3 | 0.3 |
| 3 | ln4 | 4 | 0.4 |
指数总和为 10。损失只取真实类别对应的概率:当 yt=2 时,Lt=−ln0.3≈1.2040;正确类别概率升至 0.6,损失降至约 0.5108。实际 256 类完全均匀时,ln256≈5.5452 是一个有用的数量级检查。
概念检查
| 检查问题 | 结论 | 原因 |
|---|
| 16 kHz 改为 8 kHz,μ-law 会自动减半点数吗? | 不会 | μ-law 改振幅编码;重采样才改时间上的采样密度 |
| 训练损失很小,能认定说话自然吗? | 不能 | 训练读取真实历史,自由生成读取自己的结果;第 04 篇用执行图对照 |
正在连接 GitHub 评论…