02|注意力对齐与多帧自回归解码
返回 Tacotron 总览 · 前一篇:声学表示与 CBHG · 下一篇:联合训练与波形重建
编码器输出一排文本记忆。注意力解码器每一步提出一个查询,按相关程度读取整排记忆,再决定接下来一小段声音的特征。本篇把“对齐”落实为权重、向量和明确的帧索引。
1. 加性注意力的计算路径
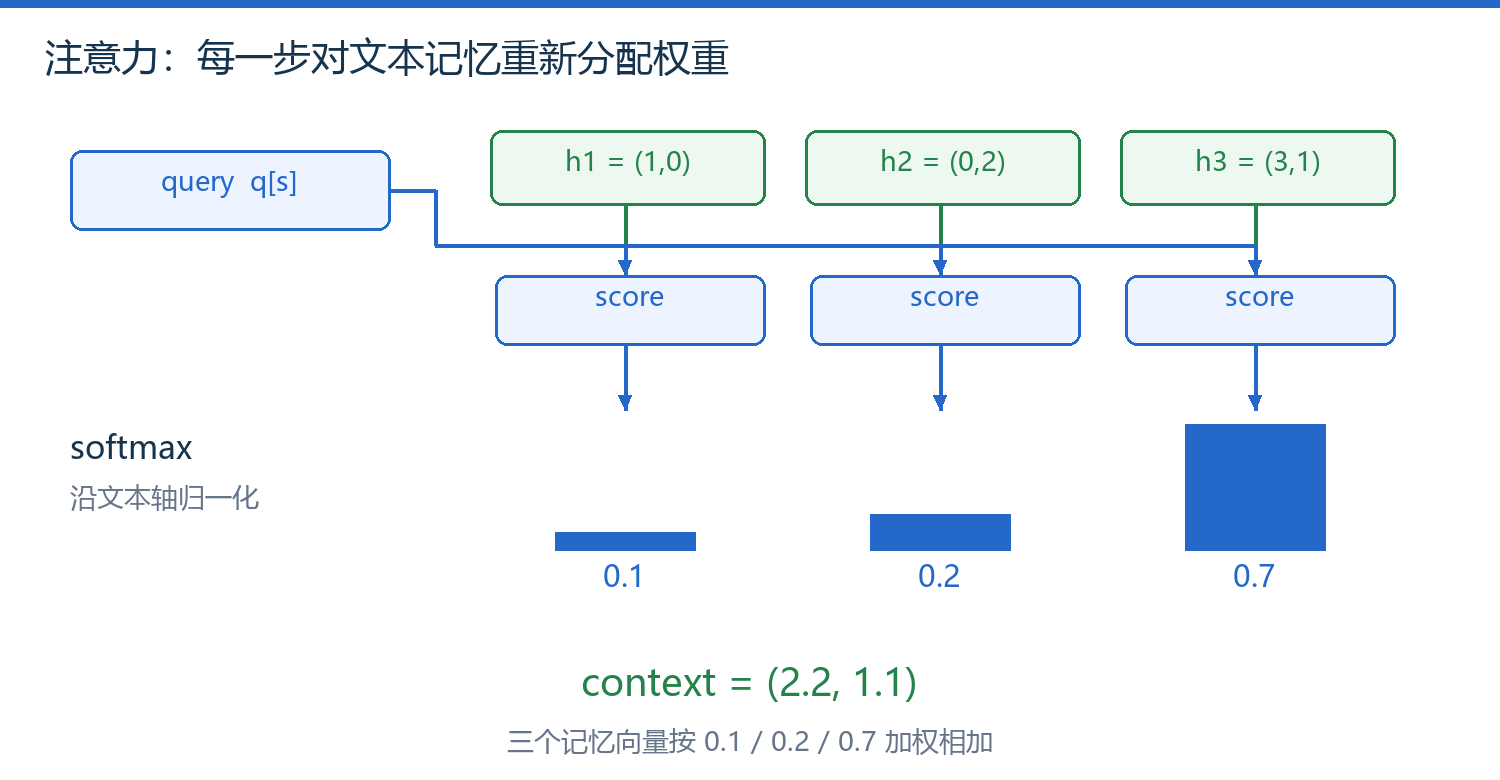
图 1|一次软读取:分数、权重与上下文
原版使用基于内容的 tanh 注意力。下面是这一类加性注意力的通用写法;它给每个文本位置一个分数,经 softmax 后得到加权上下文。
注意力:全部符号与形状
| 符号 | 含义、形状与约定 |
|---|---|
| 声学解码步索引;每一步可输出多帧。 | |
| 当前文本位置,从 1 到 。 | |
| softmax 分母遍历全部有效文本位置时使用的求和索引。 | |
| 当前句子的有效文本长度。 | |
| 第 个文本记忆,形状 ;原版编码器输出维度 。 | |
| attention RNN 当前查询,形状 ;原版为 256 维。 | |
| 文本记忆维数。 | |
| 查询维数。 | |
| 注意力内部投影维数;是实现超参数。 | |
| 查询投影矩阵,形状 。 | |
| 文本记忆投影矩阵,形状 。 | |
| 广播到每个位置的偏置,形状 。 | |
| 逐元素双曲正切非线性。 | |
| 将匹配特征转为标量的可学习向量,形状 。 | |
| 转置,使 与特征向量做内积。 | |
| 未归一化的标量分数,没有物理单位。 | |
| 指数函数,将有限分数变为正数。 | |
| 当前步对位置 的权重,非负,沿有效文本位置之和为 1。 | |
| 按下标范围求和;归一化与聚合都沿文本轴进行。 | |
| 上下文向量,形状 ,是本步读取到的文本信息。 |
这三个阶段的职责不同:打分函数比较查询和记忆;softmax 约束相对权重;加权和把可变长度的文本压成固定维度的当前上下文。softmax 不是在 mel 频率通道上计算。
2. 数值例与 padding 掩码
为突出归一化,假设打分层已经输出 ,三个记忆分别为 、、。这组分数是便于手算的教学输入,不是训练得到的参数。
| 位置 | 分数取指数 | 权重 | 加权后的记忆 |
|---|---|---|---|
| 1 | 1 | ||
| 2 | 2 | ||
| 3 | 7 | ||
| 求和 | 10 | 1 |
上下文是连续的加权混合,网络不需要先做不可微的“选中第几个字”。
如果批内句子长度不同,补齐位置不是有效字符。将这些位置的分数置为负无穷后再 softmax,权重变成 0。仅把补齐向量设为零不够:它的分数仍可能占走概率质量。至少保留一个有效位置,否则全是负无穷会使归一化无效。
# energy: [B,N]; valid: [B,N] bool; memory: [B,N,Dh]
energy = energy.masked_fill(~valid, -float('inf'))
weights = energy.softmax(dim=-1)
context = torch.bmm(weights[:, None, :], memory).squeeze(1)
bmm 的两项分别是 和 ,结果为 ;移除中间的长度 1 轴,得到每条句子的上下文。完整代码中的掩码测试固定有效记忆,只大幅改动补齐位置,检查输出不变。
3. 注意力 RNN 与声学解码器
不能把注意力理解为一次静态文本池化:查询随解码状态变化。上一帧进入 decoder pre-net,再更新 attention RNN;上下文与 attention RNN 输出拼接,交给声学 decoder RNN,最后线性投影成一组 mel 帧。原论文 §3.3
| 模块 | 本步读取 | 本步产物 | 跨步状态 |
|---|---|---|---|
| Decoder pre-net | 上一步最后一帧或 GO | 低维非线性特征 | 无递归状态 |
| Attention RNN | pre-net 特征、上一查询状态 | 当前查询 | attention GRU 隐状态 |
| Attention | 查询、整句文本记忆 | 权重与 context | 原版内容注意力没有显式时长表 |
| Decoder RNN | 查询与 context 拼接 | 声学隐藏表示 | 两层 GRU 隐状态 |
| 输出投影 | 声学隐藏表示 | 个不同 mel 帧 | 无递归状态 |
减少解码步数不等于减少频谱帧数,也不等于把同一帧复制 r 次。
原论文配置每步投影到 个值,再重排为两个 80 维帧。两个帧有独立输出坐标,但共享当前解码步的注意力上下文。这样可以让对齐更早向前推进;代价是步内没有再次计算注意力,过大的分组会降低对齐更新的细粒度。
4. Reduction factor 与反馈索引
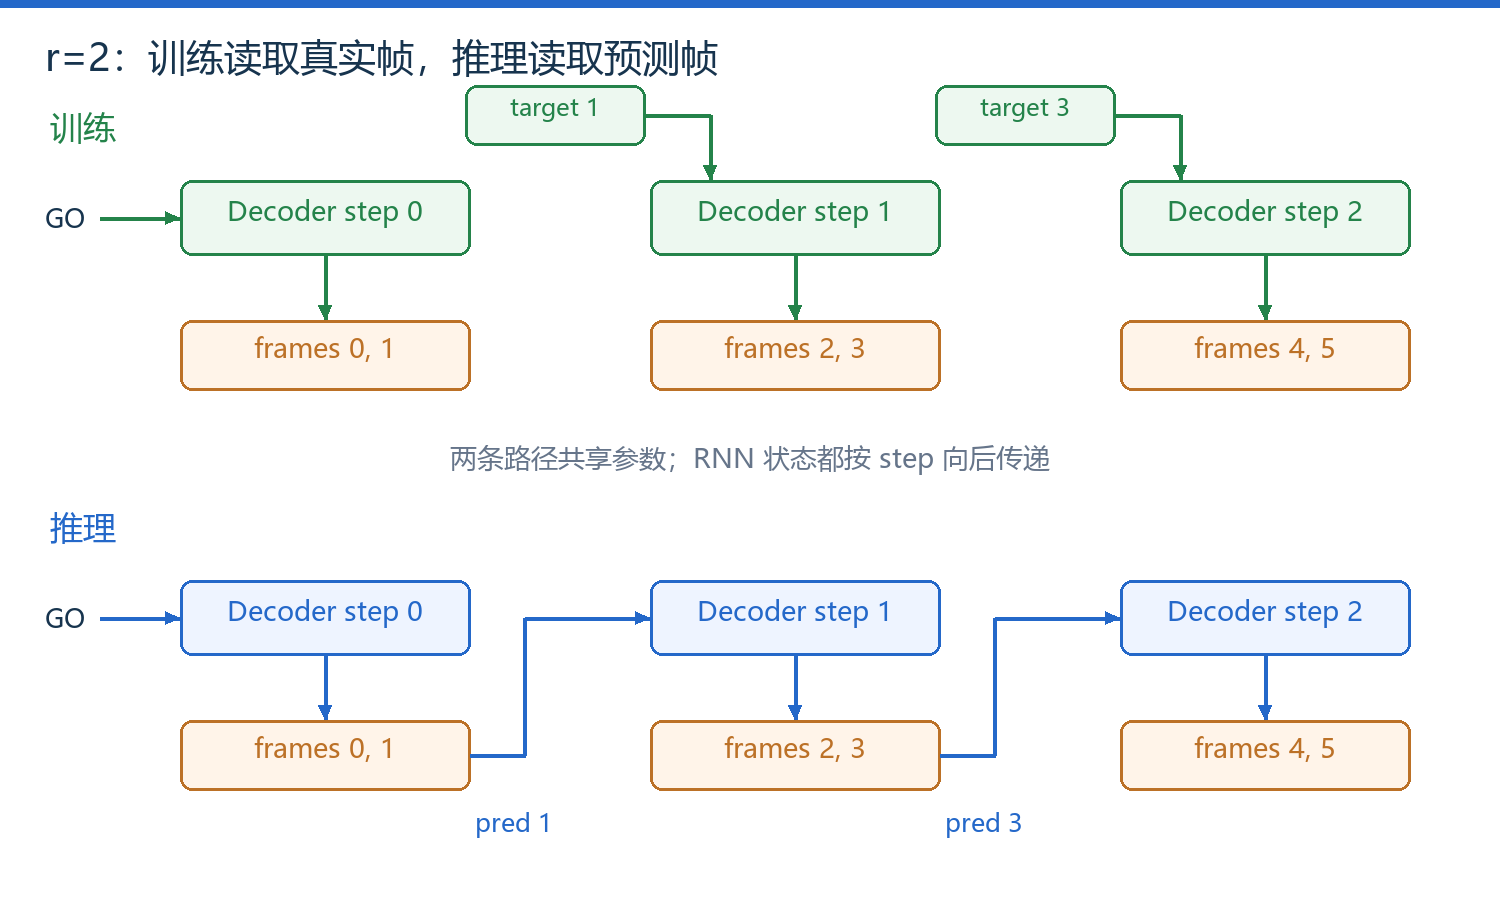
图 2|相同权重下,训练与推理的历史来源不同
本节用从 0 开始的帧索引与解码步索引。设真实序列包含 6 帧,每帧 80 个通道,:
| 解码步 | 训练输入 | 推理输入 | 当前预测与目标帧 |
|---|---|---|---|
| 0 | 全零 GO 帧 | 全零 GO 帧 | 0、1 |
| 1 | 真实帧 1 | 预测帧 1 | 2、3 |
| 2 | 真实帧 3 | 预测帧 3 | 4、5 |
一般关系如下:
多帧输出:长度与反馈约定
| 符号 | 含义、形状与约定 |
|---|---|
| 目标声学帧数,例 6;不等于波形采样点数。 | |
| 每步输出帧数,例 2。 | |
| 解码步数,例 3;训练需将最后不足一组的目标补齐。 | |
| 向上取整,例如 5 帧、每组 2 帧需要 3 步。 | |
| 从 0 开始的解码步,范围 。 | |
| 每帧 mel 通道数,原版 80;教学程序缩为 8。 | |
| 本步预测块,形状 ;覆盖帧 到 。 | |
| 实数集合,表示连续输出而非离散字符类别。 | |
| 本步送入 pre-net 的一帧,形状 。 | |
| 全零 GO 向量,提供第一步的起始输入。 | |
| 真实第 帧,形状 ;这里 是上一组最后一帧。 | |
| 预测第 帧;帽子表示模型预测。 |
例:,先将目标补为 6 帧;第三步仍读取真实帧 3,输出第 4 帧和一个补齐帧。究竟让补齐帧参与多少损失属于训练设计,不能在不同实现中默认相同。
Teacher forcing 提供真实历史,但 RNN 仍有跨步递归依赖;它不自动让所有解码步并行。
训练时历史干净,推理时历史含自身误差,这种输入分布差异会积累。原版用 pre-net 的 dropout 等设计改善泛化,并未采用 scheduled sampling;将“随机喂预测帧”写成原版默认训练法是不准确的。
5. 对齐矩阵的可视化判读
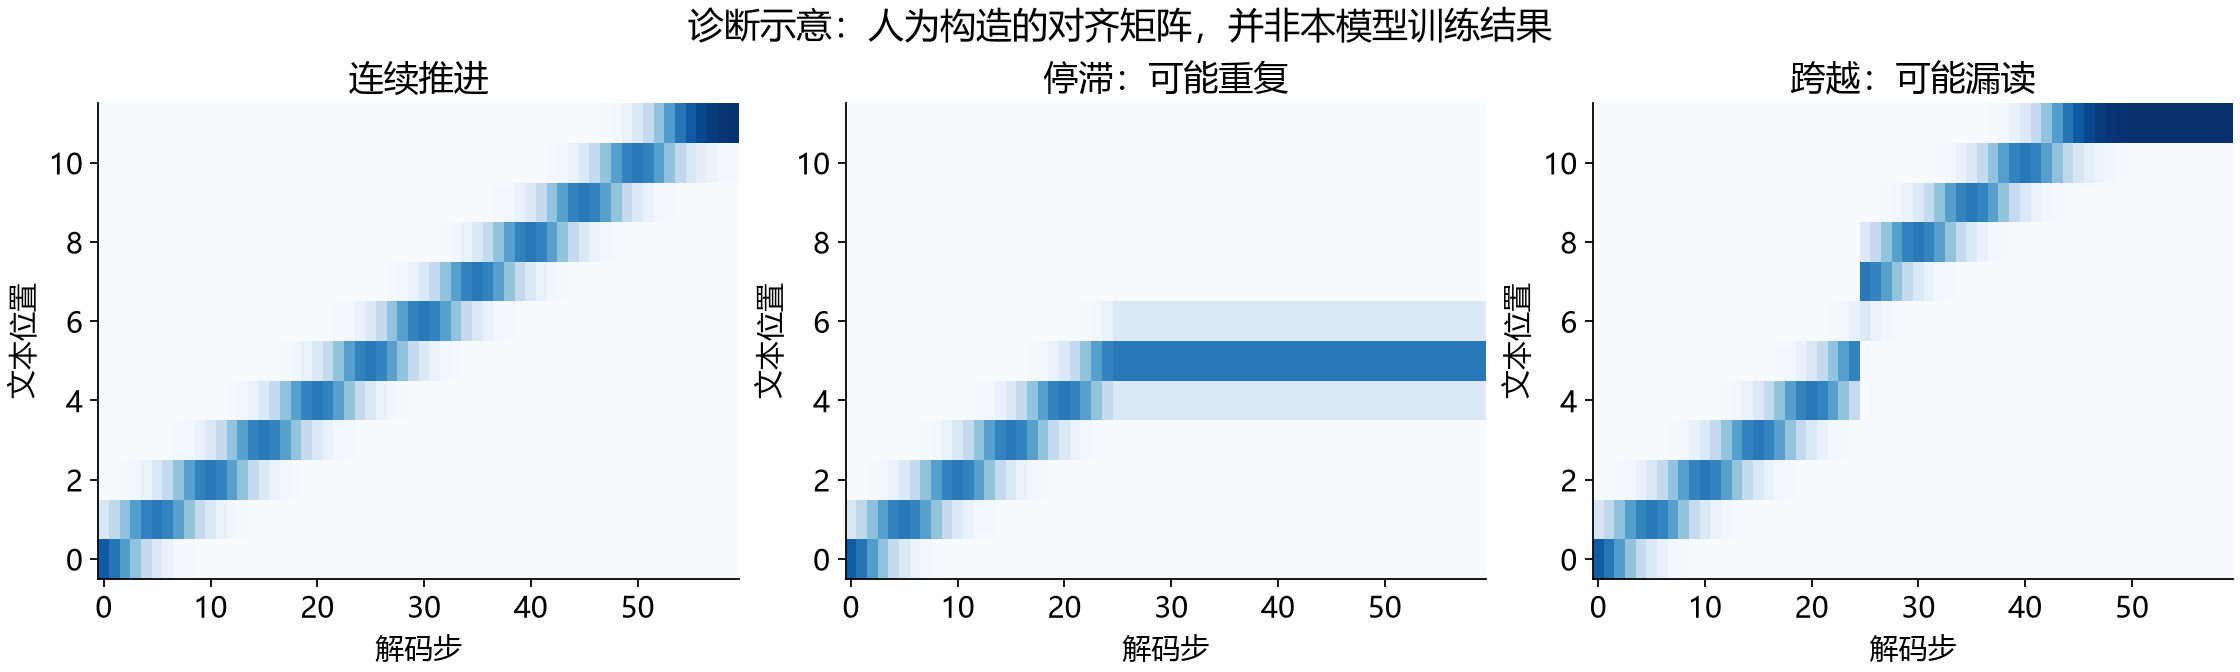
图 3|对齐诊断示意,非训练测量
横轴是解码步,纵轴是文本位置,颜色越深表示权重越高。不要把本文坐标方向与其他论文图默认视作一致;有的实现会把两个轴转置。
| 模式 | 可能听到的问题 | 下一项核查 |
|---|---|---|
| 连续向前、局部有宽度 | 通常符合逐段朗读 | 仍需检查发音和停顿,斜线不是音质保证 |
| 长时间停在同一位置 | 重复音或拖长 | 反馈索引、推理历史偏移、长句训练覆盖 |
| 大范围突然跨越 | 漏字、跳词 | 文本清洗、注意力稳定性、分组过大 |
| 大面积分散 | 发音模糊、对齐未形成 | padding、长度、学习率与配对数据 |
原版内容注意力没有严格单调约束,所以正确的软对齐需要从数据中学得;后续专门的对齐与时长建模正是在解决这一脆弱环节。
正在连接 GitHub 评论…