11|Qwen3-TTS:低帧率多码本与双轨生成
Qwen3-TTS 技术报告讨论 25Hz 与 12Hz 两条路线;截至 2026-09-29 核对的官方开源模型列表集中在 12Hz 系列。报告中出现某种架构,不等于同名权重已经开放。本文把架构与可下载模型分开说明。技术报告 · 官方仓库
12Hz 是系列名称;技术报告的实际音频帧率为 12.5 Hz。
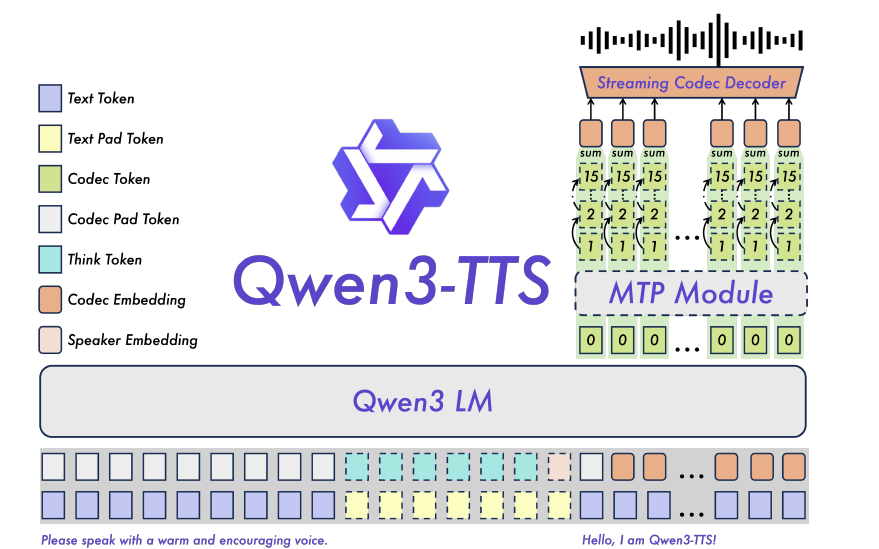
图 1|Qwen3-TTS 的文本与音频双轨、主干与 MTP
深入学习路径
分别解释码本调度、音频编码、时间主干/帧内预测和缓存验证,明确帧率与实际计算路径。
| 子文章 | 阅读目标 |
|---|---|
| 01|多码本调度:展平、延迟模式与局部自回归 | 展平、延迟模式与局部自回归 |
| 02|12Hz 音频编码:语义监督、残差码本与因果解码 | 语义监督、残差码本与因果解码 |
| 03|双轨主干与 MTP:跨帧状态、帧内预测与训练目标 | 跨帧状态、帧内预测与训练目标 |
| 04|流式推理与缓存:因果等价、首包边界与并发状态 | 因果等价、首包边界与并发状态 |
各篇包含独立机制解释、张量或状态约定、数值例与验证边界。代码集中入口见 深入机制实验附录。
1. 两条 tokenizer 路线
| 路线 | 中间表示 | 波形恢复 |
|---|---|---|
| 报告中的 25Hz | 单层语音 token | 分块 DiT/流匹配到 mel,再到波形 |
| 已发布 12Hz 系列 | 语义层 + 15 层声学 RVQ | 因果 codec 解码,支持增量波形恢复 |
12Hz tokenizer 的首层接受语义教师引导,其余层补充声学信息。与 EnCodec 的重建取向相比,这里专门组织了语义与声学分工,但仍不能假定信息被完美正交分离。
2. 时间主干与帧内预测
较大的主干沿时间轴推进,预测当前帧首层编号;MTP 模块在该帧内生成其他码本,避免让大主干沿全部码本展平后的序列运行。文本与音频双轨同时组织进输入,不是先让通用聊天模型写一段描述,再交给独立 TTS API。
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 8 秒音频的时间帧数,本例 100。 | |
| tokenizer 帧率,12.5 帧/秒。 | |
| 音频时长,单位秒;此处 D 不表示隐藏维度。 |
| 对 8 秒教学例 | 数量 | 含义 |
|---|---|---|
| 时间帧 | 100 | 大主干的音频时间尺度 |
| 每帧码本 | 16 | 1 层语义与 15 层声学残差 |
| 全部编号 | 1,600 | 若全部展平会显著增加时间序列长度 |
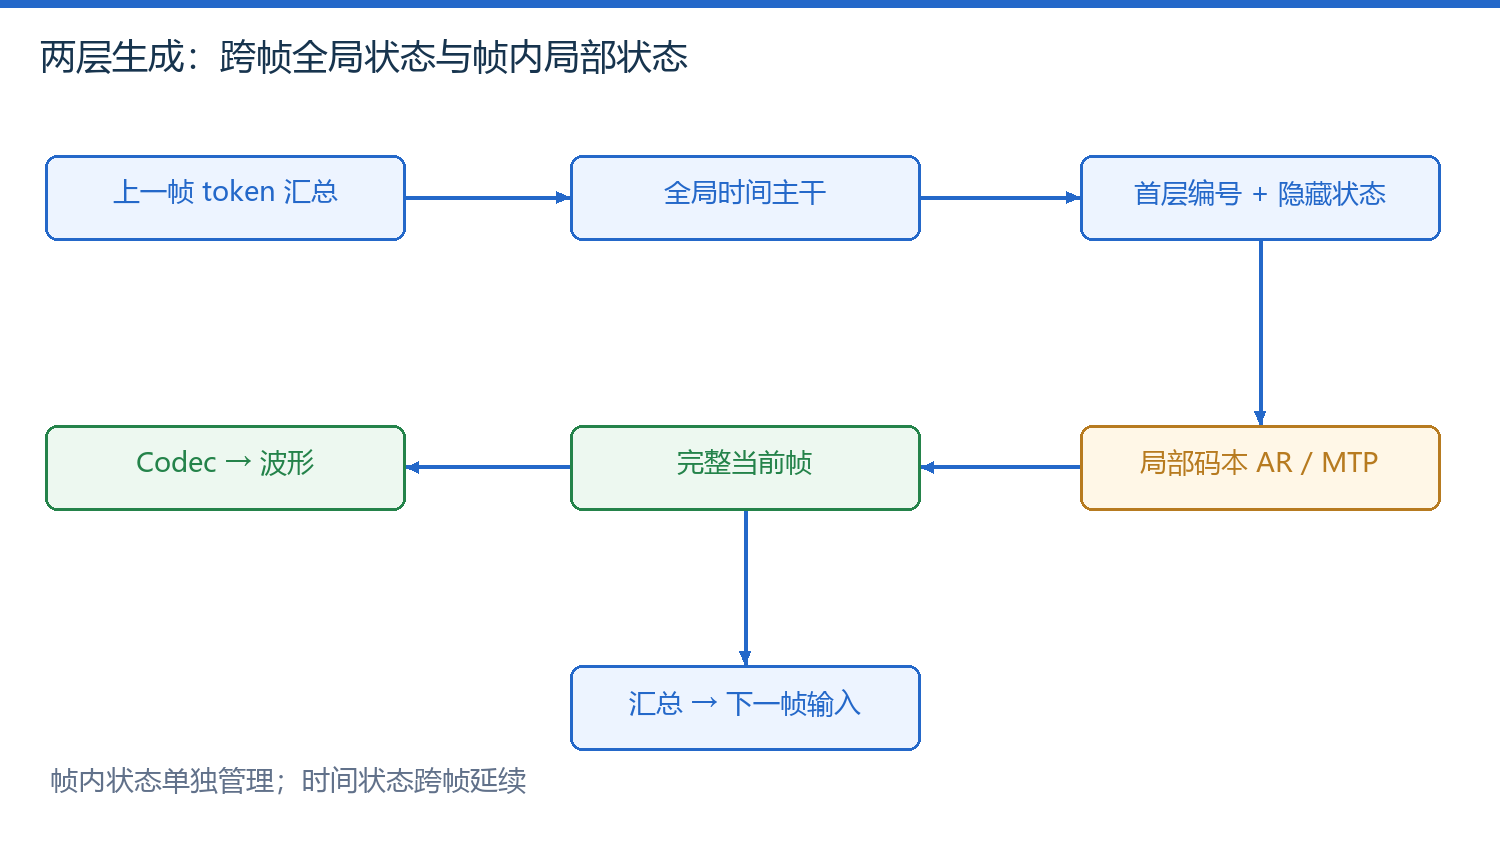
图 2|时间自回归与帧内码本预测分离后的计算路径
3. 已发布模型的接口区别
| 模型类型 | 用户输入 | 主要用途 |
|---|---|---|
| Base,0.6B / 1.7B | 参考音频,按模式提供文字 | 声音克隆与进一步微调 |
| CustomVoice,0.6B / 1.7B | 预设音色、目标文字 | 固定音色生成;指令能力以具体型号为准 |
| VoiceDesign,1.7B | 自然语言描述、目标文字 | 根据描述设计声音 |
官方表格对 1.7B CustomVoice 标出指令控制,而 0.6B CustomVoice 没有同样标记。不能仅因方法签名可以传入字段,就推断所有权重具备相同能力。指定声音、描述设计声音和参考录音克隆声音也不能混为一种任务。
按任务选择正确 checkpoint,比统一加载一个型号后修改提示词更可靠。
4. 延迟数字的正确读取
技术报告表 2 中,12Hz-0.6B、单并发配置的 LM 首包 token 时间为 93 ms,tokenizer 解码约 4 ms,合计首包约 97 ms;1.7B 对应 97+4=101 ms。评测使用其优化后的推理引擎,这些数字不是本地 CPU 实测。
把 1.7B 的 LM 时间 97 ms 当成完整首包延迟,会漏掉后续解码。
继续 码本调度与代码地图,再看 2026 年多路线进展。
专题导航:TTS 总目录
正在连接 GitHub 评论…