附录|Tacotron 教学实现:代码导读与完整源码
这个脚本演示 CBHG 文本编码 → 加性注意力 → 多帧自回归声学解码,并运行数值与结构断言。它不读取语音文件,不会生成可试听声音;随机声学目标只用于验证计算路径。
1. 运行入口与代码地图
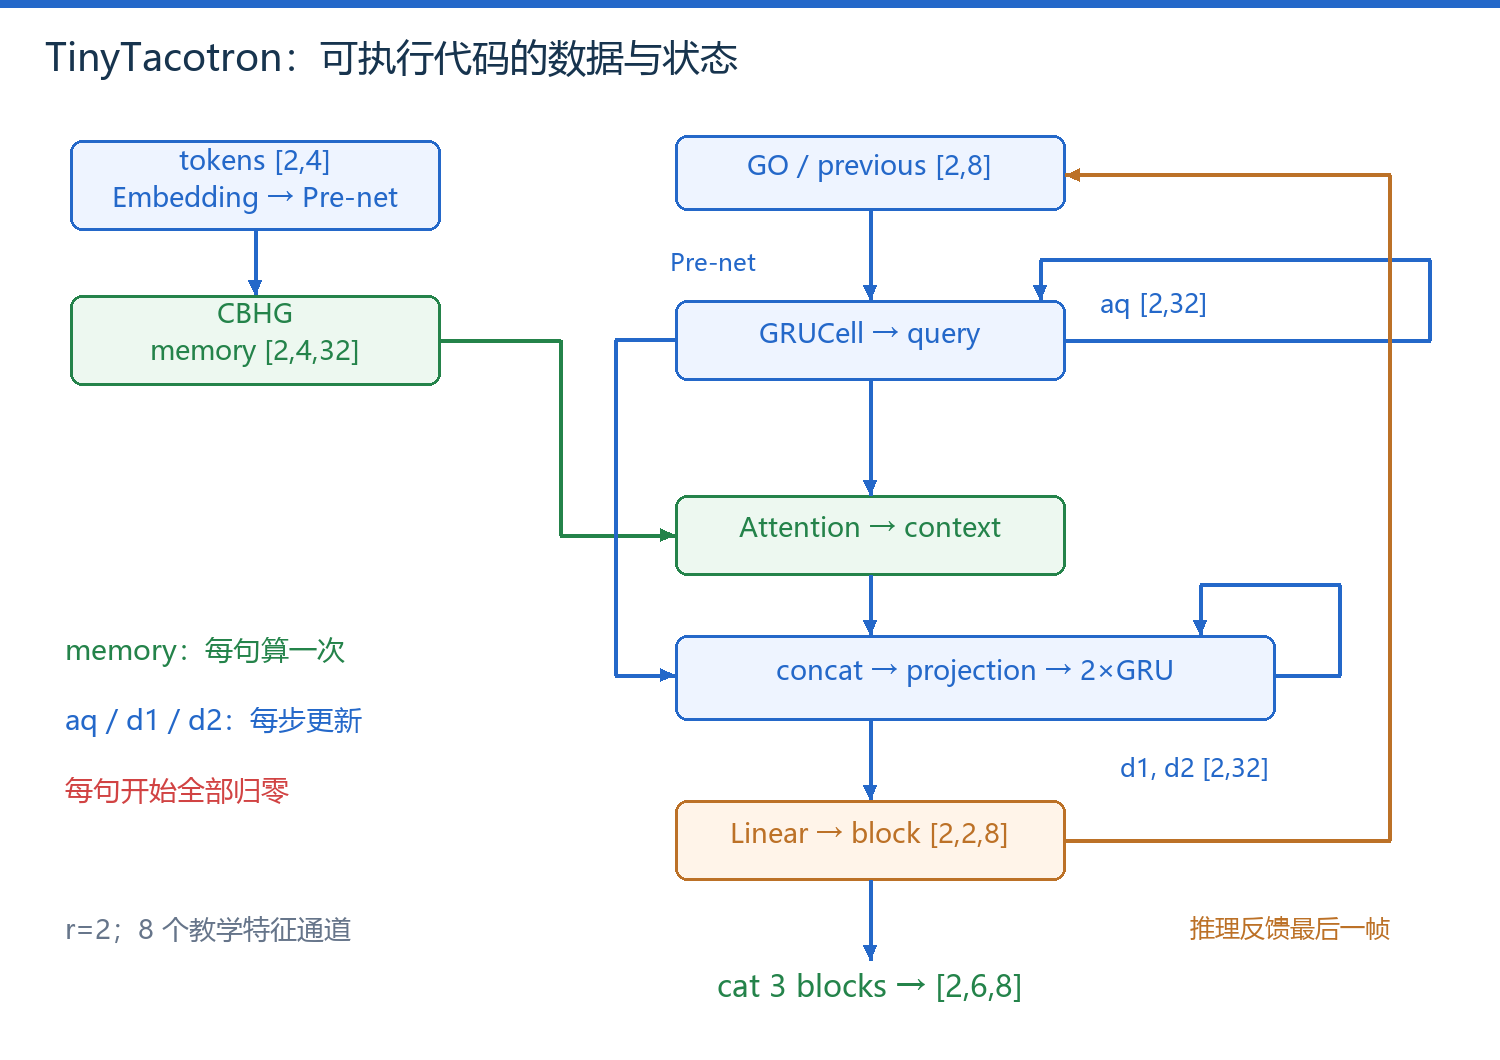
图 1|源码阅读地图:先编码一次,再逐步解码
forward 同时支持 teacher forcing 和预测反馈;两者使用同一组参数。
| 类或函数 | 责任 | 应对照的机制 |
|---|---|---|
SameConv | 显式左右 padding、卷积、BN | 偶数核保持长度 |
Highway | 门控变换路径与保留路径 | 逐维混合,不是普通残差相加 |
CBHG | 卷积 bank、池化、投影、残差、highway、BiGRU | 并行多尺度文本编码 |
Attention | 打分、mask、归一化、加权和 | 查询如何读取全部文本位置 |
TinyTacotron | 编码、状态初始化、逐步输出与反馈 | 上一步最后一帧决定下一步输入 |
verify | 固定种子并执行断言,保存 JSON | 将讲解的索引和数值关系实际验证 |
接口使用批优先布局:tokens [B,N]、targets [B,T,M]、预测 [B,T,M]、注意力 [B,S,N]。 是批大小, 是文本长度, 是声学帧数, 是声学通道数, 是解码步数;本例依次为 2、4、6、8、3。更详细的接口表与简化项见实现篇。
2. 环境、命令与产物
实测环境:Python 3.12.14、PyTorch 2.14.0+cpu、Windows、CPU 单线程。以下安装命令使用 PyTorch CPU 源;这是本次实测版本记录,不要求把未来环境固定到它。
python -m venv .venv
.venv\Scripts\python -m pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu
.venv\Scripts\python tacotron_core.py
保存下方代码为 tacotron_core.py,放在有写权限的目录。运行后打印检查记录,并在脚本旁写出 results/checks.json。如果环境已有可用 PyTorch,可直接运行脚本,不必重复安装。
| 核心产物 | 本次输出 |
|---|---|
| 预测形状 | [2,6,8] |
| 对齐形状 | [2,3,4] |
| 手算 context | 约 [2.2,1.1] |
| 未来目标扰动的前缀差 | 0.0 |
| 同一扰动的后缀差 | 约 0.113219 |
| 参数数 | 33872 |
命令正常退出且断言通过,表示所列测试通过。
这不表示模型学会了发音、稳定对齐或自然语音;本脚本没有训练集、后处理声码器与音质评测。
3. 完整源码
源码按“基础层 → 编码器 → 注意力 → 解码循环 → 验证入口”排列。首次阅读优先对照图 1 的 TinyTacotron.forward,再按调用返回各模块;无需先逐行通读全部辅助层。
tacotron_core.py:完整脚本(默认展开,可收起)
python185 行
"""CPU teaching model: CBHG + additive attention + reduction decoder.

This is NOT a trained speech synthesizer. Run this file to verify the tensor
contracts and numerical examples used in the accompanying articles.
"""
import json
import platform
from pathlib import Path

import torch
from torch import nn
from torch.nn import functional as F


class SameConv(nn.Module):
    def __init__(self, cin, cout, kernel, activate=True):
        super().__init__()
        self.kernel, self.activate = kernel, activate
        self.conv = nn.Conv1d(cin, cout, kernel)
        self.bn = nn.BatchNorm1d(cout)

    def forward(self, x):
        # [B,C,N]; even kernels require asymmetric padding.
        left = (self.kernel - 1) // 2
        x = self.conv(F.pad(x, (left, self.kernel - 1 - left)))
        x = self.bn(x)
        return F.relu(x) if self.activate else x


class Highway(nn.Module):
    def __init__(self, width):
        super().__init__()
        self.h, self.g = nn.Linear(width, width), nn.Linear(width, width)
        nn.init.constant_(self.g.bias, -1.)

    def forward(self, x):
        gate = torch.sigmoid(self.g(x))
        return gate * F.relu(self.h(x)) + (1 - gate) * x


class CBHG(nn.Module):
    def __init__(self, width=16, bank_size=4):
        super().__init__()
        self.bank = nn.ModuleList(SameConv(width, width, k)
                                  for k in range(1, bank_size + 1))
        self.p1 = SameConv(width * bank_size, width, 3)
        self.p2 = SameConv(width, width, 3, activate=False)
        self.highway = nn.Sequential(*(Highway(width) for _ in range(4)))
        self.rnn = nn.GRU(width, width, batch_first=True, bidirectional=True)

    def forward(self, x):
        residual = x.transpose(1, 2)
        bank = torch.cat([conv(residual) for conv in self.bank], dim=1)
        # Pool width 2, stride 1; -inf prevents padded values winning max.
        pooled = F.max_pool1d(F.pad(bank, (0, 1), value=-float('inf')), 2, 1)
        x = (self.p2(self.p1(pooled)) + residual).transpose(1, 2)
        x = self.highway(x)
        return self.rnn(x)[0]  # [B,N,2*width]


class Attention(nn.Module):
    def __init__(self, memory_dim, query_dim, attention_dim):
        super().__init__()
        self.key = nn.Linear(memory_dim, attention_dim, bias=False)
        self.query = nn.Linear(query_dim, attention_dim, bias=False)
        self.score = nn.Linear(attention_dim, 1, bias=False)
        self.bias = nn.Parameter(torch.zeros(attention_dim))

    def forward(self, query, memory, valid):
        if not valid.any(dim=1).all():
            raise ValueError('Every text must contain at least one valid token')
        energy = self.score(torch.tanh(self.key(memory)
                            + self.query(query)[:, None, :] + self.bias)).squeeze(-1)
        energy = energy.masked_fill(~valid, -float('inf'))
        weights = energy.softmax(dim=-1)  # normalization over text positions
        context = torch.bmm(weights[:, None, :], memory).squeeze(1)
        return context, weights


class TinyTacotron(nn.Module):
    def __init__(self, vocab=12, width=16, mel_dim=8, reduction=2):
        super().__init__()
        self.mel_dim, self.reduction, self.width = mel_dim, reduction, width
        self.embedding = nn.Embedding(vocab, width)
        self.encoder_prenet = nn.Sequential(nn.Linear(width, width), nn.ReLU(),
                                           nn.Dropout(.5))
        self.encoder = CBHG(width)
        self.decoder_prenet = nn.Sequential(nn.Linear(mel_dim, width), nn.ReLU(),
                                           nn.Dropout(.5))
        self.attention_rnn = nn.GRUCell(width, width * 2)
        self.attention = Attention(width * 2, width * 2, width)
        self.input_projection = nn.Linear(width * 4, width * 2)
        self.decoder1 = nn.GRUCell(width * 2, width * 2)
        self.decoder2 = nn.GRUCell(width * 2, width * 2)
        self.output = nn.Linear(width * 2, reduction * mel_dim)

    def forward(self, tokens, targets=None, steps=None):
        # Demo batch uses equal-length unpadded text. Attention itself accepts
        # a mask; variable-length encoder batching requires packing/masking too.
        if (tokens == 0).any():
            raise ValueError('Demo encoder requires unpadded, equal-length text')
        memory = self.encoder(self.encoder_prenet(self.embedding(tokens)))
        valid = torch.ones_like(tokens, dtype=torch.bool)
        batch = tokens.shape[0]
        previous = memory.new_zeros(batch, self.mel_dim)  # GO frame
        aq = memory.new_zeros(batch, self.width * 2)
        d1, d2 = torch.zeros_like(aq), torch.zeros_like(aq)
        if targets is not None:
            if targets.shape[1] % self.reduction:
                raise ValueError('Pad target length to a multiple of reduction')
            steps = targets.shape[1] // self.reduction
        if steps is None:
            raise ValueError('Demo inference requires an explicit step limit')
        blocks, alignments = [], []
        for s in range(steps):
            aq = self.attention_rnn(self.decoder_prenet(previous), aq)
            context, weights = self.attention(aq, memory, valid)
            decoder_input = self.input_projection(torch.cat([aq, context], -1))
            d1 = self.decoder1(decoder_input, d1)
            d2 = self.decoder2(d1 + decoder_input, d2)
            block = self.output(d2 + d1 + decoder_input)
            block = block.reshape(batch, self.reduction, self.mel_dim)
            blocks.append(block)
            alignments.append(weights)
            previous = (targets[:, (s + 1) * self.reduction - 1]
                        if targets is not None else block[:, -1])
        return torch.cat(blocks, 1), torch.stack(alignments, 1)


def verify():
    torch.manual_seed(7)
    torch.set_num_threads(1)
    # Exact hand example: exp energies proportional to [1,2,7].
    weights = torch.tensor([1., 2., 7.]).log().softmax(-1)
    context = weights @ torch.tensor([[1., 0.], [0., 2.], [3., 1.]])
    torch.testing.assert_close(context, torch.tensor([2.2, 1.1]))
    att = Attention(4, 4, 3)
    memory, query = torch.randn(2, 4, 4), torch.randn(2, 4)
    mask = torch.tensor([[1, 1, 1, 0], [1, 1, 0, 0]], dtype=torch.bool)
    _, a = att(query, memory, mask)
    altered = memory.clone()
    altered[~mask] = 1e4
    c1, _ = att(query, memory, mask)
    c2, _ = att(query, altered, mask)
    torch.testing.assert_close(c1, c2)
    assert a[~mask].count_nonzero() == 0
    torch.testing.assert_close(a.sum(-1), torch.ones(2))
    model = TinyTacotron().eval()
    text = torch.tensor([[1, 2, 3, 4], [4, 3, 2, 1]])
    target = torch.randn(2, 6, 8)
    pred, alignment = model(text, target)
    changed = target.clone()
    changed[:, 3] += 9  # 0-based frame 3 feeds decoder step 2 only.
    perturbed, _ = model(text, changed)
    prefix_error = (pred[:, :4] - perturbed[:, :4]).abs().max().item()
    suffix_delta = (pred[:, 4:] - perturbed[:, 4:]).abs().max().item()
    assert prefix_error == 0 and suffix_delta > 1e-5
    generated, _ = model(text, steps=3)
    assert pred.shape == generated.shape == (2, 6, 8)
    assert alignment.shape == (2, 3, 4)
    model.train()
    training_pred, _ = model(text, target)
    loss = F.l1_loss(training_pred, target)
    loss.backward()
    gradients = {name: p.grad.abs().sum().item() for name, p in model.named_parameters()
                 if p.grad is not None}
    assert all(torch.isfinite(p.grad).all() for p in model.parameters() if p.grad is not None)
    assert gradients['embedding.weight'] > 0 and gradients['attention.score.weight'] > 0
    result = dict(python=platform.python_version(), torch=torch.__version__, device='CPU',
                  seed=7, weights=weights.tolist(), context=context.tolist(),
                  predicted_shape=list(pred.shape), alignment_shape=list(alignment.shape),
                  padding_context_error=(c1-c2).abs().max().item(),
                  target_prefix_error=prefix_error, target_suffix_delta=suffix_delta,
                  l1_loss=loss.item(), gradient_tensors=len(gradients),
                  parameters=sum(p.numel() for p in model.parameters()),
                  limitation='Random initialization; no speech training or MOS evaluation')
    out = Path(__file__).parent / 'results'
    out.mkdir(exist_ok=True)
    (out / 'checks.json').write_text(json.dumps(result, indent=2), encoding='utf-8')
    print(json.dumps(result, indent=2))


if __name__ == '__main__':
    verify()
4. 常见运行问题
| 现象 | 原因与处理 |
|---|---|
缺少 torch | 在实际运行脚本的 Python 环境中安装,不要把包安装到另一个解释器 |
| 文本输入含 0 报错 | 演示不支持变长补齐编码;请使用等长且非零 ID,或补全长度处理 |
| 目标帧数不是 2 的倍数 | 先制定 padding 与损失策略,再按 reduction 补齐;不要静默丢掉最后一帧 |
未指定 steps 报错 | 本演示没有自动结束预测,推理必须提供步数上限 |
| 想查看“训练后的对齐” | 本脚本只有随机初始化和一次反传,不能把输出热力图当作训练成功证据 |
原理依据:Tacotron 原论文。教学维度、残差连接代码、等长输入约束和有限步数推理均为本专题明确记录的实现选择。
正在连接 GitHub 评论…