04|PyTorch 实现:网络结构、训练与生成
这一篇把模型变成可执行的学习流程。先沿图走完一次前向,再精确划出损失范围,最后比较“已知真实历史的训练”和“靠自己继续写下去的生成”。完整脚本在源码附录,本页只保留需要解释的局部代码。
先分两件事: 训练更新参数;自由生成固定参数,持续更新历史与缓存。
1. 网络架构与张量流
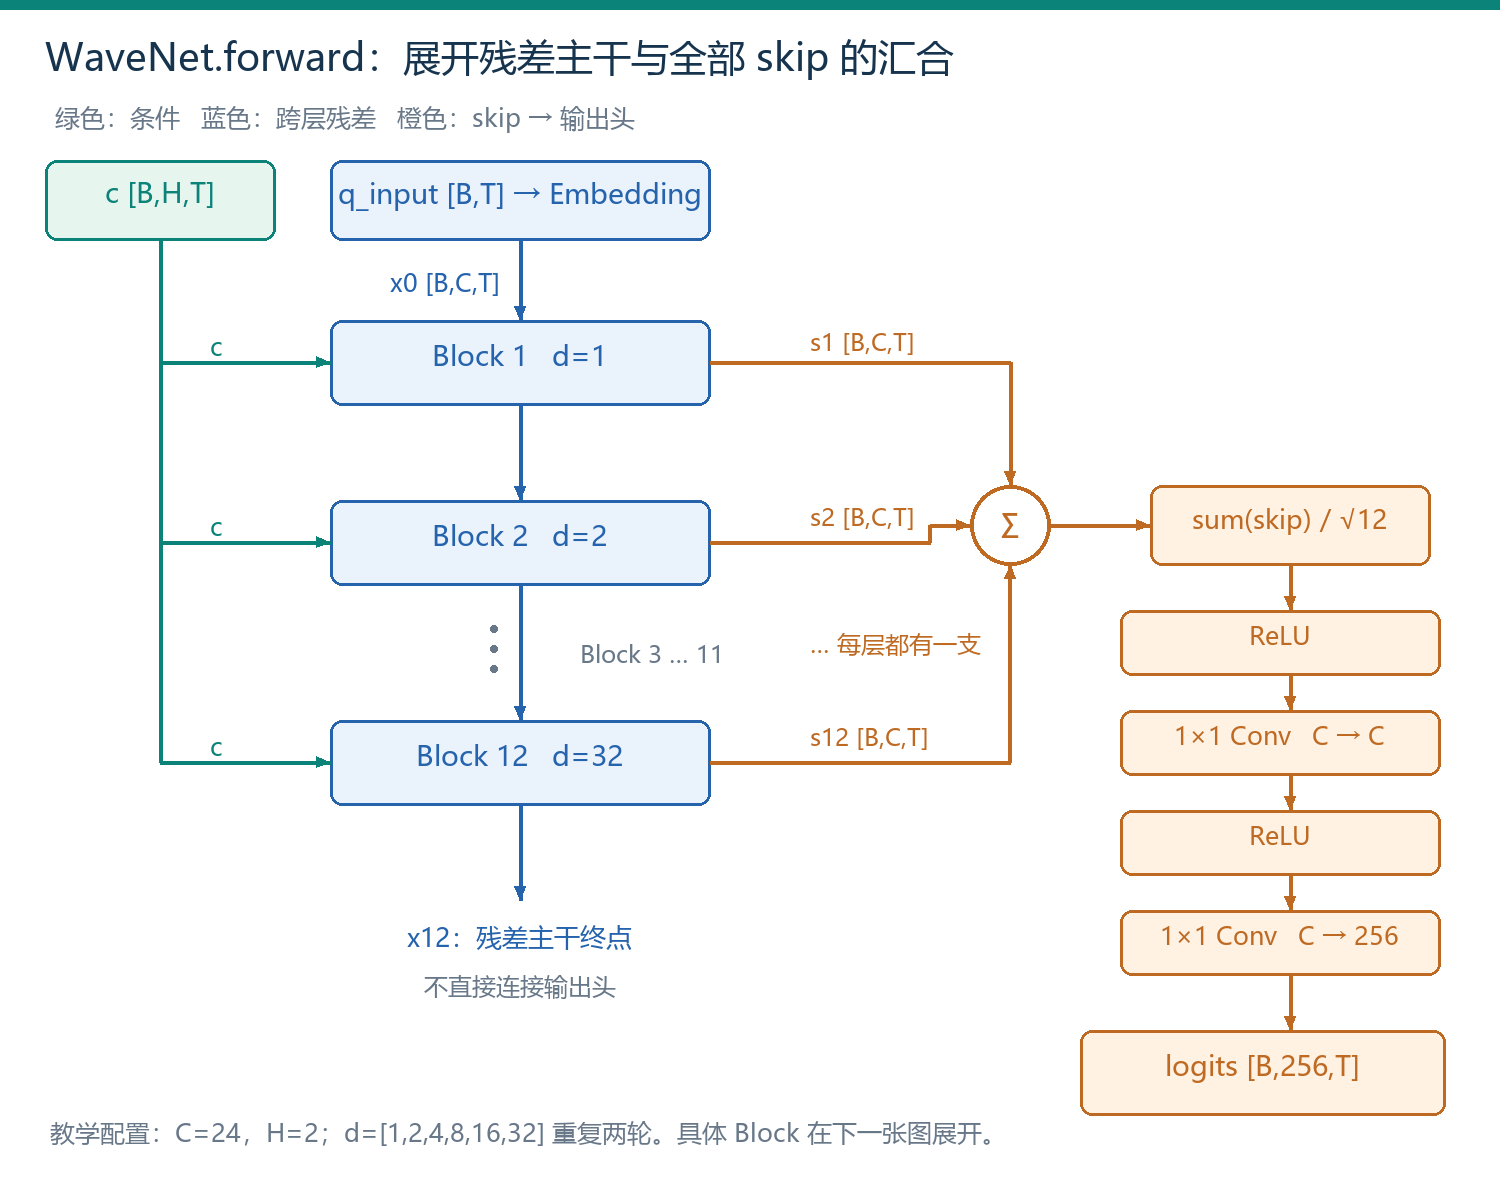
图 1|教学模型架构与张量流
沿图中间蓝色主干读取:整数类别先查 embedding,得到连续特征;12 个块各自产生新的残差与一份 skip;残差继续往下,所有 skip 汇总后交给分类头。注意图中末层残差没有直接连到 head;head 读取的是所有 skip 的汇合结果。 同一组权重如何用于 step,在第 3 节的时间展开图中单独画出。
| 阶段 | 实际形状 | 应如何理解 |
|---|---|---|
| 原始 | [4,513],long | 四条量化序列 |
| inp / target | [4,512],long | 相差一个采样点的输入与标签 |
| cond_target | [4,2,512],float | 每个目标的频率与振幅条件 |
| 查 embedding | [4,512,24] | 256 个类别各有一个 24 维向量 |
| 转置后 / 各块残差 | [4,24,512] | Conv1d 的批、通道、时间布局 |
| 门控卷积 | [4,48,512] | 为两支各准备 24 通道 |
| 各层 skip / 汇总结果 | [4,24,512] | 可逐元素相加的同形状特征 |
| 最终 logits | [4,256,512] | 每个时间位置的 256 个类别分数 |
网络维度说明
| 数学记号 | 含义、单位与示例 |
|---|---|
| 批大小,本例为 。 | |
| 网络时间长度,本例为 。 | |
| 隐藏通道数,本例为 。 | |
| 条件通道数,本例为 。 | |
| 输出类别数,本例为 。 |
embedding 的 是表示维度,不会把输出类别数从 改为 。
各块 skip 汇合后送入输出头:。
Skip 汇合:符号说明
| 数学记号 | 含义、单位与示例 |
|---|---|
| 残差块数;本例为 。 | |
| 残差块的索引。 | |
第 层产生的 skip,形状为 [B,C,T]。 | |
汇总并缩放后的张量,形状仍为 [B,C,T]。 |
除以 是本教学实现的尺度选择,不保证特征方差严格不变,因为各层输出并不独立。输出头依次是 ReLU、1×1 卷积 、ReLU、1×1 卷积 。
以下代码与图逐项对应:x 保留主干,skips 收集支路,最后一次调用 head 得到 logits。这里不做 softmax,训练损失会处理它。
def forward(self, q_input, cond_target):
    x = self.embedding(q_input).transpose(1, 2)
    skips = []
    for block in self.blocks:
        x, skip = block(x, cond_target)
        skips.append(skip)
    return self.head(torch.stack(skips).sum(0) / math.sqrt(len(skips)))
2. 训练目标与损失计算
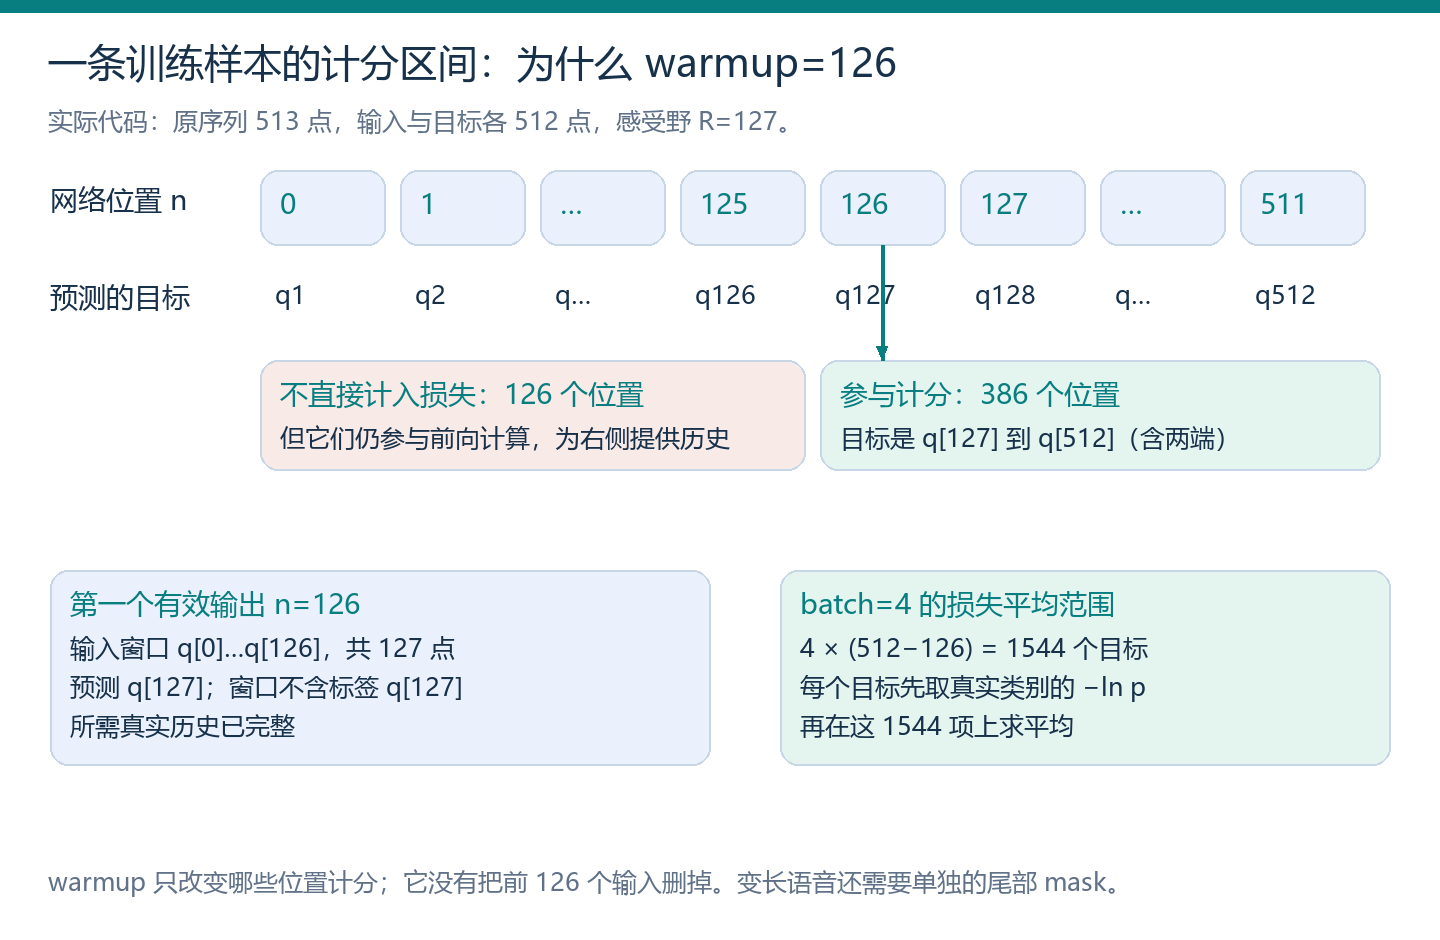
图 2|warmup 与有效计分区间
读图中分界线:感受野 =127 时,输出 =126 第一次拥有完整的 127 个真实输入 …,预测目标 。更早的输出含左补零上下文。本例保留这些位置的前向计算,但不直接把它们的分类损失计入平均。
令 =−1=126 为 warmup 长度,损失为:
批平均交叉熵:符号与计分范围
| 数学记号 | 含义、单位与示例 |
|---|---|
| 一次 batch 上平均的交叉熵,单位为 nats/目标点。 | |
| 批大小,本例为 。 | |
| batch 内的样本索引,从 到 。 | |
| 网络时间长度,本例为 。 | |
| 网络输出位置,参与计分的范围为 。 | |
| 不直接计分的前缀长度,本例为 。 | |
| 感受野大小,本例为 ,因此 。 | |
| 第 条波形在目标位置 的真实类别。 | |
| 某个候选类别的编号。 | |
| 样本 在输出位置 对类别 的预测概率。 | |
| 自然对数。 | |
| 在参与计分的样本与时间位置上累加。 | |
| 参与平均的目标数,本例为 。 |
| 核算项 | 代入计算 | 结果 |
|---|---|---|
| 每条样本的计分位置 | ||
| 一个 batch 的计分目标 | ||
| 假设各目标正确类别概率均为 | nats/目标 | |
| 上述相同损失再求平均 | 仍为 |
真实训练应逐项取负对数,再平均。 各位置概率通常不同,“平均概率再取对数”会得到另一个目标。
代码的 cross_entropy 要求 logits 类别轴在 dim=1,目标是整数类别,不是 one-hot,也不是浮点振幅。它内部处理 log-softmax;先手工 softmax 再传进去会改变计算。CrossEntropyLoss 文档
logits = model(inp, cond_target)
warmup = model.receptive_field - 1
loss = F.cross_entropy(logits[:, :, warmup:], target[:, warmup:])
optimizer.zero_grad(set_to_none=True)
loss.backward()
nn.utils.clip_grad_norm_(model.parameters(), 1.0)
optimizer.step()
| 更新步骤 | 作用 |
|---|---|
zero_grad | 清除上轮梯度 |
backward | 沿当前计算图计算梯度 |
| 梯度裁剪 | 限制总梯度范数 |
| 优化器更新 | 根据梯度修改参数 |
warmup 只屏蔽前缀的直接计分,不切断前缀对后续目标的影响。 变长真实语音还需要尾部有效长度 mask;本例四条数据等长,没有这一项。
3. 并行训练与自回归生成
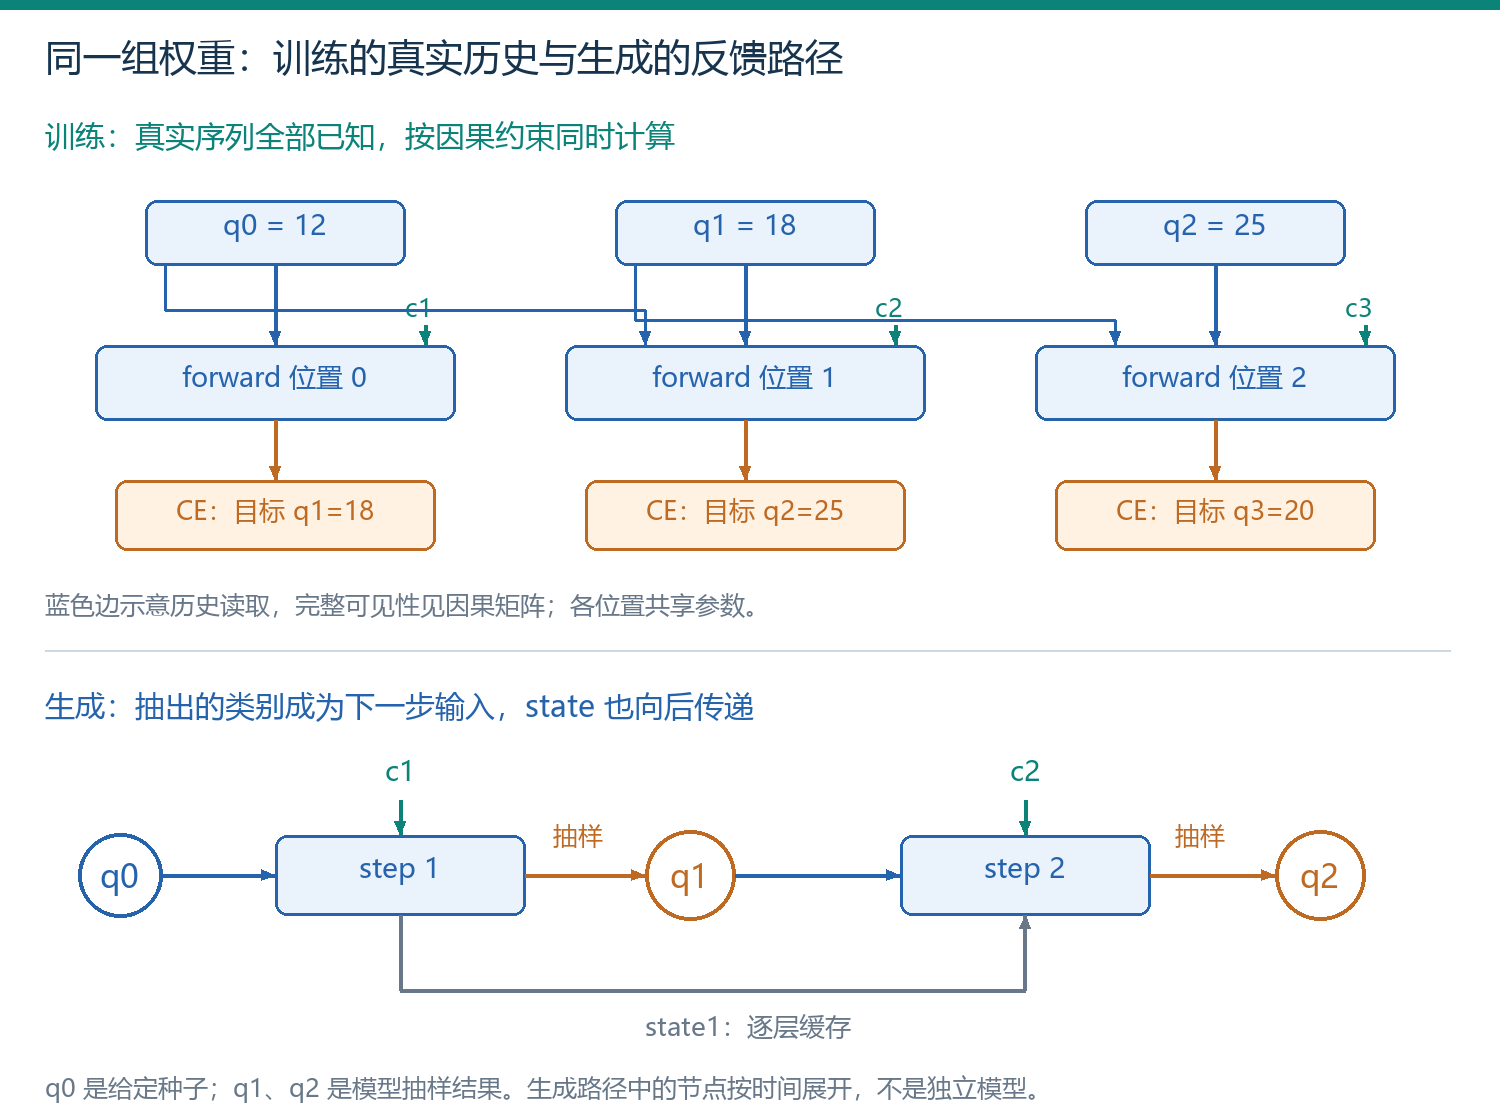
图 3|并行训练与逐点生成
上半图的训练已经拿到真实序列 [12,18,25,20],一次前向同时预测三个目标。这称为 teacher forcing(教师强制):每项预测的历史来自真实数据,因果结构负责遮住尚不该读取的部分。
下半图只有种子 12 已知。若第一步抽到 17,第二步就必须使用 17,而不是偷偷换成训练数据中的 18。先前的小偏差会改变后续分布。这是低训练损失不足以证明长时间生成稳定的原因。
一次生成调用的输入是 previous[B]、当前目标的条件 [B,H],以及各层队列组成的 state;输出是 logits [B,Q] 和更新后的 state。以下三行负责预测与抽样,外层循环把新编号继续送回来:
logits, state = model.step(previous, cond_future[:, :, i], state)
probs = torch.softmax(logits / temperature, dim=1)
previous = torch.multinomial(probs, 1).squeeze(1)
i 是本次生成的步号,cond_future 的时间轴只覆盖要生成的新点。multinomial 按概率抽取类别,不等于取最大项。所有新点生成完后,才能用 μ-law 解码为振幅;脚本当前只执行短序列生成检查,不写 WAV。
温度通过 改变抽样分布。
温度抽样:符号说明
| 数学记号 | 含义、单位与示例 |
|---|---|
| 必须大于 的无量纲温度参数。 | |
| 类别 的 logit。 | |
| 当前考察的类别编号。 | |
| 分母的求和索引,遍历所有类别。 | |
| 类别总数。 | |
| 在温度 下,抽取类别 的概率。 |
保持原分布;较小温度让分布更集中。
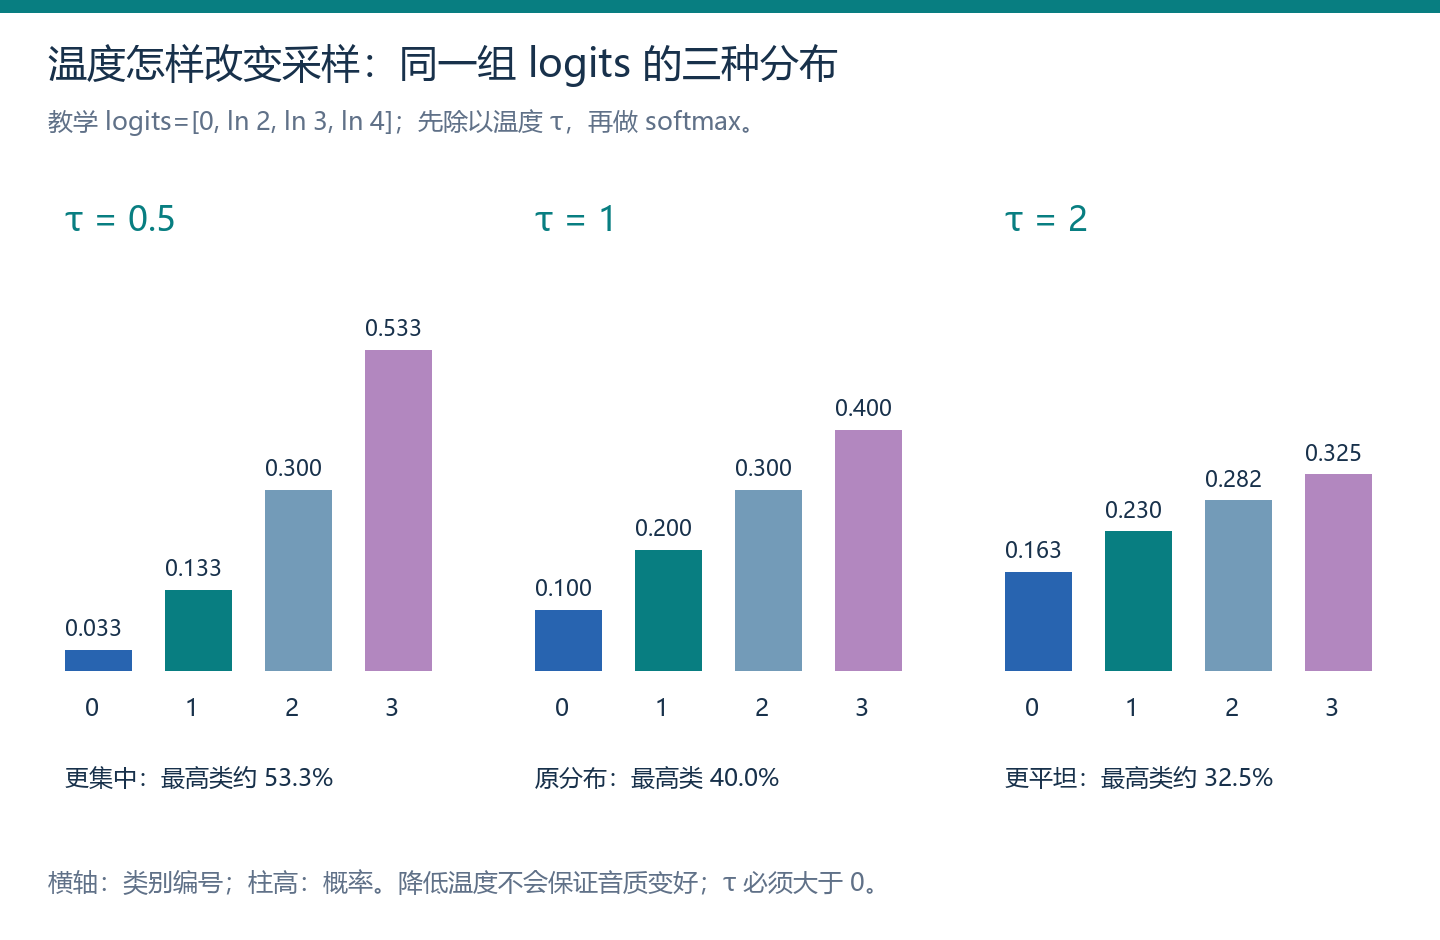
图 4|温度对抽样分布的影响
固定图中的 logits 为 ,只改变温度:
| 温度 | 缩放后取指数的结果 | 最高类别的概率 |
|---|---|---|
| 约 |
降低温度使该分布更集中,但不能修复标签错位,也不保证音质更好。
自测:能否让每次生成都只调用 forward 而不写缓存?可以,重复计算已有前缀也能得到下一步分布,但浪费工作。下一篇解释怎样把已有中间结果保存下来,同时保持网络函数不变。
正在连接 GitHub 评论…