02|位置敏感注意力:累计对齐与解码状态
Tacotron 2 的输入文字有 个位置,输出有 个 mel 帧;一个字符通常持续多个帧,因此不能让“第几个解码步”直接等于“第几个字符”。注意力每步决定从哪些文字位置读取信息,位置敏感机制再利用过去的读取轨迹,降低重复或跳过文字的风险。
本文沿着一次解码步追踪状态。前置知识只需 softmax、卷积和 LSTM。原论文 §2.2描述累计注意力;NVIDIA 实现还把上一帧和累计权重一起交给位置卷积。两者不能混为逐行相同的代码。
位置敏感注意力提供推进线索,并不构成严格的单调路径约束。
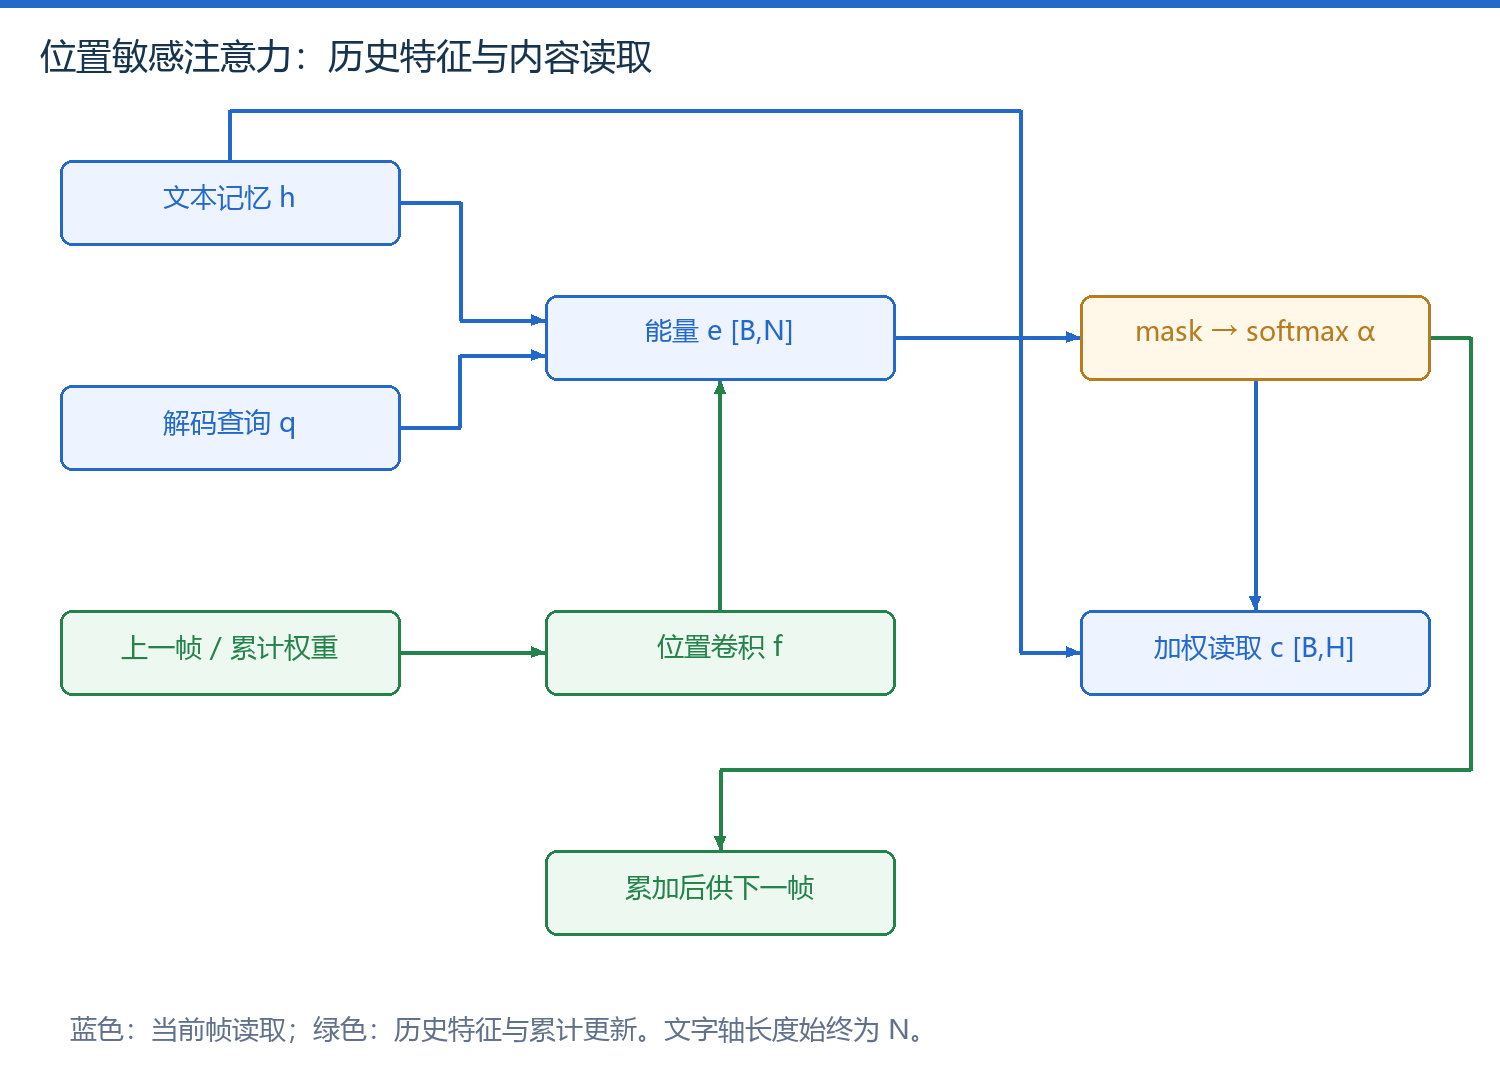
图 1|内容记忆、解码状态与历史对齐共同决定读取位置
1. 解码状态与历史信息
| 对象 | 教学形状 | 从哪里来 | 下一步是否保留 |
|---|---|---|---|
| 文本记忆 | [B,N,H]=[1,4,512] | 卷积编码器与双向 LSTM | 全句固定 |
| 注意力查询 | [B,Q]=[1,1024] | 解码循环状态 | 继续更新 |
| 上一步权重 | [B,N]=[1,4] | 上一次 softmax | 保留一份 |
| 累计权重 | [B,N]=[1,4] | 历史权重逐步相加 | 持续累积 |
| 上一帧 mel | [B,F]=[1,80] | 训练读标签,推理读预测 | 反馈给 prenet |
这里 是批大小, 是文字位置数, 是编码维度, 是查询维度, 是 mel 频带数。N=4 只是演示;padding 位置必须从 softmax 中排除。位置卷积沿文字轴移动,不能误放在 mel 时间轴上。
2. 从历史权重到上下文向量
把上一时刻的累计权重卷积成位置特征,再与内容和查询相加。下面先用论文式累计特征解释;若采用 NVIDIA 实现,可将上一帧权重与累计权重堆成两个输入通道。
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 当前及历史解码帧索引;从 1 开始。 | |
| 文字索引与有效文字位置集合;padding 不属于该集合。 | |
| 第 t 帧对文字 n 的概率,单行和为 1。 | |
| 之前读到该位置的权重总量;可大于 1,不是概率分布。 | |
| 沿文字轴卷积得到的位置向量;卷积核可看到相邻文字的历史。 | |
| 解码查询与第 n 个文字的编码向量。 | |
| 把三类输入投到相同注意力维度的可训练矩阵及偏置。 | |
| 可训练向量的转置,将隐藏向量压成一个未归一化标量分数。 | |
| 逐元素双曲正切与指数函数。 | |
| 加权读取到的上下文向量,维度与文字记忆一致。 |
为什么要累加?若连续三帧都集中在第一个字符,累计值会显著增大,网络有机会学到“这里已停留很久”。但 softmax 仍允许回头,是否推进由学习结果决定。严格不回退需要额外约束,不能由图上画出的斜线自动推出。
3. 注意力读取的数值示例
设三个有效分数是 0、ln 2、ln 7,第四个位置是 padding。指数分别为 1、2、7,和为 10,因此概率是 0.1、0.2、0.7、0。
| 有效文字位置 | 记忆向量 | 概率 | 加权贡献 |
|---|---|---|---|
| 0 | (1,0) | 0.1 | (0.1,0) |
| 1 | (0,2) | 0.2 | (0,0.4) |
| 2 | (3,3) | 0.7 | (2.1,2.1) |
| padding | (99,99) | 0 | (0,0) |
输出上下文为 (2.2,2.5)。即使 padding 分数误设为 100,先屏蔽再 softmax 仍会把其概率置零;先 softmax 再清零则会破坏归一化。
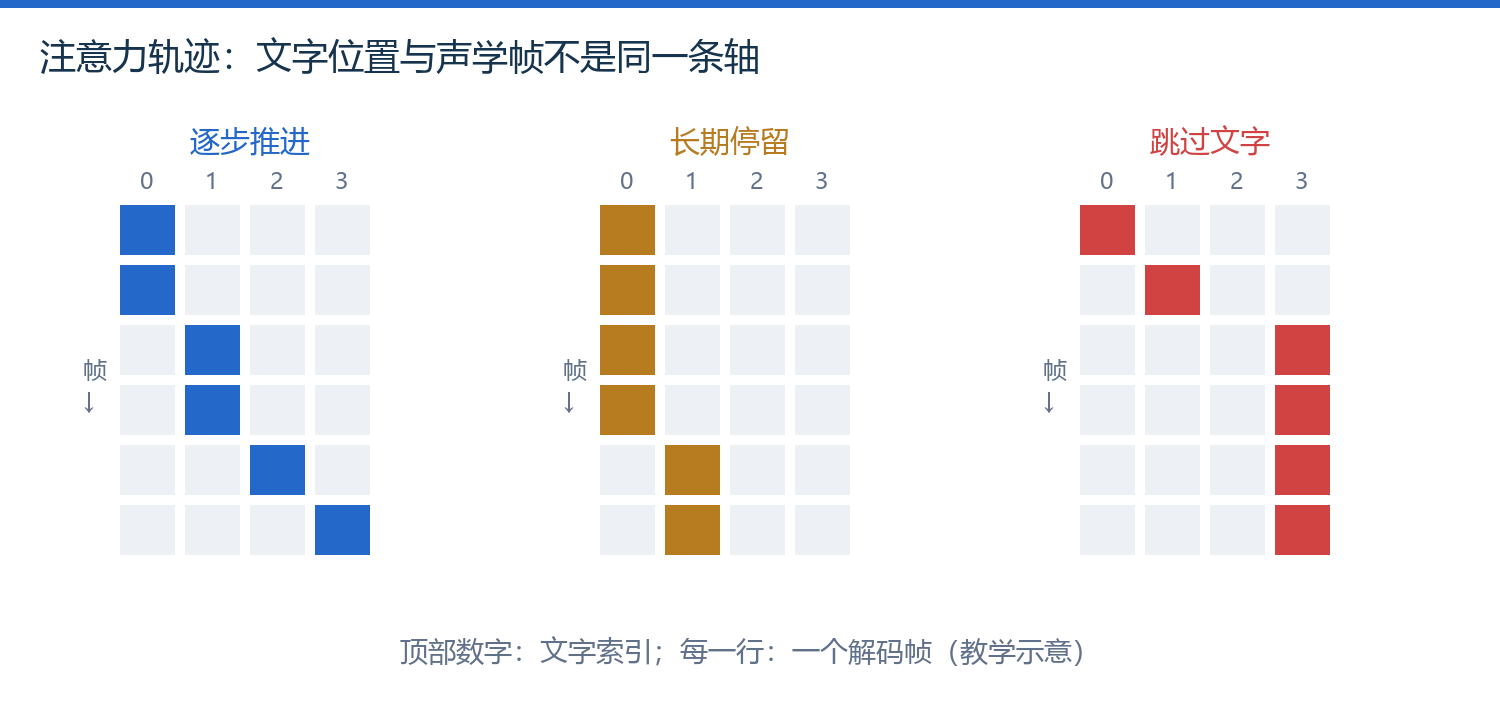
图 2|注意力矩阵中的正常推进、停留与跳跃示意
4. 核心实现及执行地图
图 1 中 energy → mask → softmax → bmm 是以下片段的边界。能量网络和循环更新放在调用方;这使我们能用已知分数独立验证读取逻辑。
def attend(energy, memory, valid):
    # energy [B,N], memory [B,N,H], valid [B,N]
    if not valid.any(-1).all():
        raise ValueError('each item needs a valid text position')
    weights = energy.masked_fill(~valid, -torch.inf).softmax(-1)
    context = torch.bmm(weights[:,None,:], memory).squeeze(1)
    return weights, context
masked_fill 将无效位置设为负无穷;[:,None,:] 把权重变为 [B,1,N],与 [B,N,H] 相乘得到 [B,1,H]。最后只移除长度为 1 的读取轴,不能用无参数 squeeze() 意外删掉批轴。
CPU 实验实际得到权重 [0.1,0.2,0.7,0] 和上下文 [2.2,2.5]。它证明遮罩和加权读取正确,尚不能证明完整网络学到了对齐。
先检查概率归一化、padding 为零和状态是否跨步累积,再判断注意力是否学会推进。
5. 根据对齐轨迹定位错误
| 现象 | 首查对象 | 区分实验 |
|---|---|---|
| 同一竖列长期高亮,语音重复 | 累计状态、prenet 输入、训练覆盖 | 对比 teacher forcing 与自由生成 |
| 跳过一大片文字 | 文字规范化、长度、异常长句 | 固定音频,将文本分句对照 |
| 尾部注意力跑到 padding | 有效长度和 softmax mask | 给 padding 极大分数,检查概率仍为零 |
| 不同句子互相影响 | 上一句的循环状态没有清空 | 单独生成与批量生成对比 |
注意力图漂亮只说明一种内部行为;仍要检查漏字、结束位置和最终音频。
继续阅读 训练、停止判断与损失,把对齐状态接到完整解码循环。
正在连接 GitHub 评论…