04|声学接口与验证:mel 配置、片段对齐与误差归因
两个系统都写着“80 维 mel”,仍然可能完全不兼容。频带数只描述形状,采样率、窗口、帧移、mel 滤波器、对数压缩及归一化共同定义数值语义。声码器看到错误语义的输入时,shape 检查通常不会报错。
本文建立可复查的接口契约,并给出逐级排错实验。官方前端 · 原论文
声学接口同时约定时间、频率和数值尺度;只对齐张量维度远远不够。
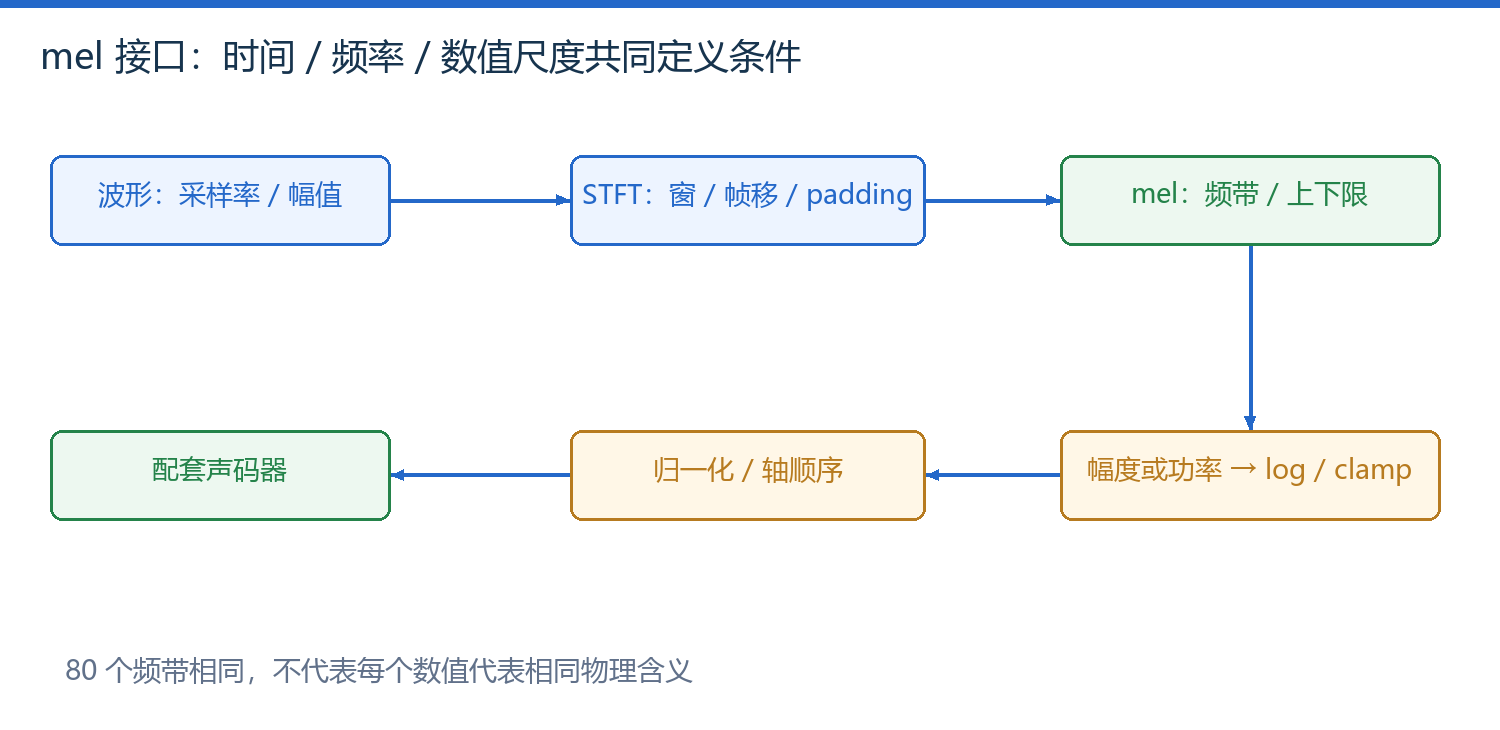
图 1|同一录音的前端处理链与声码器条件契约
1. 最小配置表
| 配置 | 控制什么 | 不匹配的后果 |
|---|---|---|
| sampling_rate | 每秒波形点数 | 播放速度、频率位置和时间换算错误 |
| n_fft / win_length | 频率网格与局部观察范围 | 频谱细节定义变化 |
| hop_length | 相邻 mel 帧间隔 | 条件长度与上采样倍率不匹配 |
| num_mels / fmin / fmax | 频带数量与覆盖范围 | 同一个下标代表不同频率区域 |
| center / padding | 边界帧及窗口中心位置 | 帧数与裁切起点错位 |
| magnitude / power | 幅度还是能量谱 | 同一声波的数值尺度变化 |
| log / clamp / normalization | 小值截断、压缩与标准化 | 动态范围与训练输入不同 |
所有字段应从模型配套配置与前端实现读取,不要用某个音频库的默认值补齐。特别是 fmax 不能超过 Nyquist 频率,即采样率的一半。
2. 声学片段与波形片段的同步裁切
先以已经对齐的帧网格解释,实际窗口边界再按前端约定处理:
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 起始 mel 帧索引,教学值 20。 | |
| 帧移,教学值 256 个采样点。 | |
| 对应波形起点,教学值 5,120 点。 | |
| 片段 mel 帧数与波形点数;S=32 时 L=8,192。 | |
| 采样率,教学值 22,050 Hz。 | |
| 片段持续时间,8,192/22,050≈0.3715 秒。 |
如果随机裁了 mel 的第 20 帧开始,却把原波形从第 0 点当目标,生成器收到的是互相矛盾的监督。优化器仍可能降低某些统计损失,但内容与瞬态对齐会受损。实际官方数据管线可先裁波形再算 mel;关键是两路共享一个时间原点。
3. 单帧偏移的时间误差与听感影响
以 256 帧移、22,050 Hz 为例,一帧约为 11.61 ms。连续元音中也许难立即发现,但短促爆破音和清浊转换可能明显错位。验证时可对条件人为平移一帧,与未平移输出对比,观察系统是否对时间契约敏感。这是建议开展的完整模型实验,本轮没有生成该对照音频。
| 输入对照 | 只改变什么 | 应保持什么 |
|---|---|---|
| 原始 mel / 平移一帧 mel | 条件时间原点 | 权重、长度、响度处理 |
| 真实 mel / 预测 mel | 条件来源 | 前端数值约定 |
| 完整推理 / 重叠分块 | 边界处理策略 | 同一输入与模型参数 |
4. 四级验证与错误归因
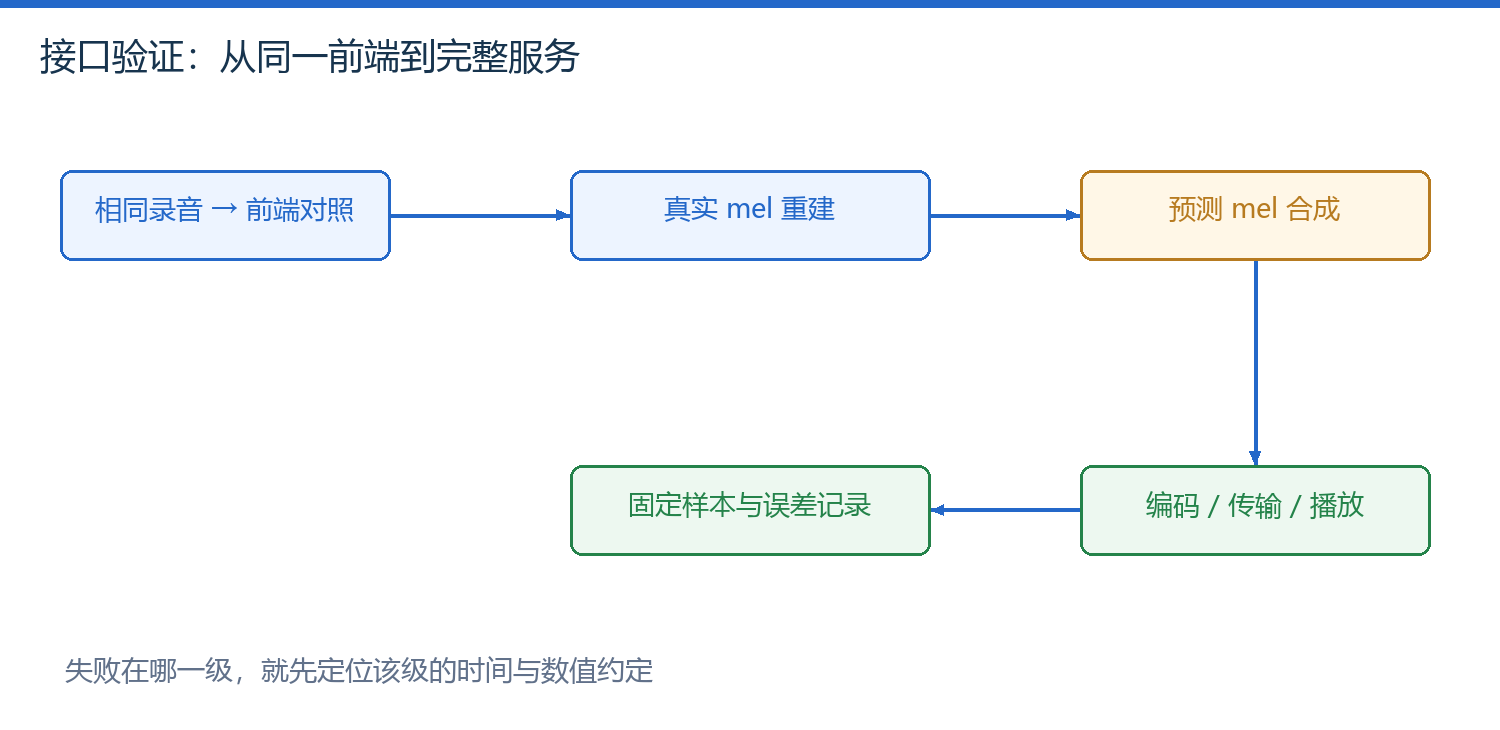
图 2|从前端一致性到完整 TTS 的逐级验证
- 前端一致性:相同录音经过训练前端与接入前端,比较帧数、频带范围和逐元素误差。必须先对齐窗口与 dtype。
- 真实 mel 重建:判断声码器是否能处理训练分布附近的输入。仍需检查声音,不能只看 loss。
- 预测 mel 重建:判断声学预测误差是否导致音质下降。若读字已错,优先查上游对齐。
- 服务链路:检查采样率头、编码格式、分块重复和播放缓存。文件写错采样率也会让正确波形听起来异常。
对每一级保存固定样本和配置哈希。失败就停留在该级定位,不必立刻更换所有模型权重。
5. 性能测量的计时边界
符号、形状与约定
| 符号 | 解释与例值 |
|---|---|
| 指定范围的计算耗时,单位秒;需注明是否含前端、传输和加载。 | |
| 输出音频时长,单位秒。 | |
| 无量纲实时因子;小于 1 表示该计时范围快于播放速度。 |
10 秒音频花 0.4 秒合成,RTF 为 0.04;但如果等完整文本 2 秒再开始,用户首音体验不会是 0.4 秒。冷启动、热推理、首包、稳态吞吐应分别记录,GPU 计时还要处理异步执行。
按验证级别保存失败样本,才能把前端错配、声学预测和波形生成问题分开。
本篇提供复现实验设计;没有把未运行的试听或 GPU 速度写成实测结果。
相关张量及梯度小实验见 深入机制实验附录。
正在连接 GitHub 评论…