06|Glow-TTS:可逆变换与单调对齐搜索
FastSpeech 需要外部教师提供时长。Glow-TTS 把对齐搜索纳入训练:先用可逆网络把 mel 映射到潜变量,再寻找潜变量与文本分布之间最合理的单调对应关系。它仍需声码器把预测 mel 变成波形。论文 · 官方代码
训练中搜索硬对齐;推理中用时长预测器,目标录音与搜索器都退出。
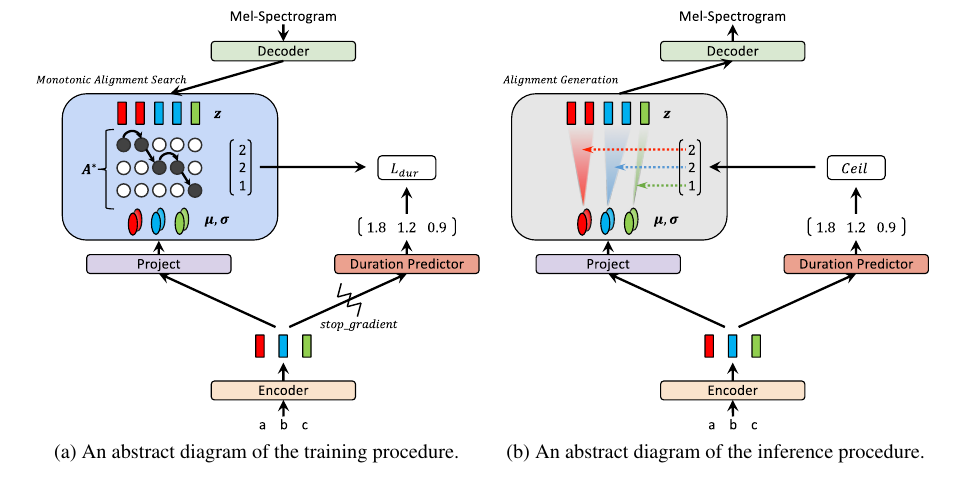
图 1|Glow-TTS 的训练与推理分别沿可逆网络的不同方向运行
1. normalizing flow 的密度换算
把复杂频谱分布映射为更易计算的条件高斯分布,需要补偿变换对体积的伸缩。否则网络只靠缩放就能改变密度数值,目标不再正确。
公式符号与约定
| 符号 | 含义、单位与约定 |
|---|---|
| 目标 mel 矩阵;公式把矩阵视为展开向量。 | |
| 与 x 维数相同的潜变量。 | |
| 参数为 θ 的可逆变换;本篇约定训练方向 x→z。 | |
| 文本及当前对齐给出的条件。 | |
| 分别在频谱空间与潜空间定义的概率密度,不是单个点的概率。 | |
| 变换相对输入的雅可比矩阵。 | |
| 行列式;绝对值表示局部体积缩放倍率。 | |
| 自然对数;乘法密度关系变成加法。 |
一维教学例 、,标准正态在 0 处密度约为 0.3989,换算后 。对数项分别约为 −0.9189 与 0.6931,和为 −0.2258。密度可以大于 1,积分概率才必须在 0 到 1 之间。
2. 对齐为什么是受约束的路径
对于每个声学帧,文本侧给出各音素下的潜变量似然得分。只允许“停留在当前音素”或“前进一个音素”,就能把朗读顺序约束成网格中的单调路径。普通无约束 argmax 可能跳字或倒退。
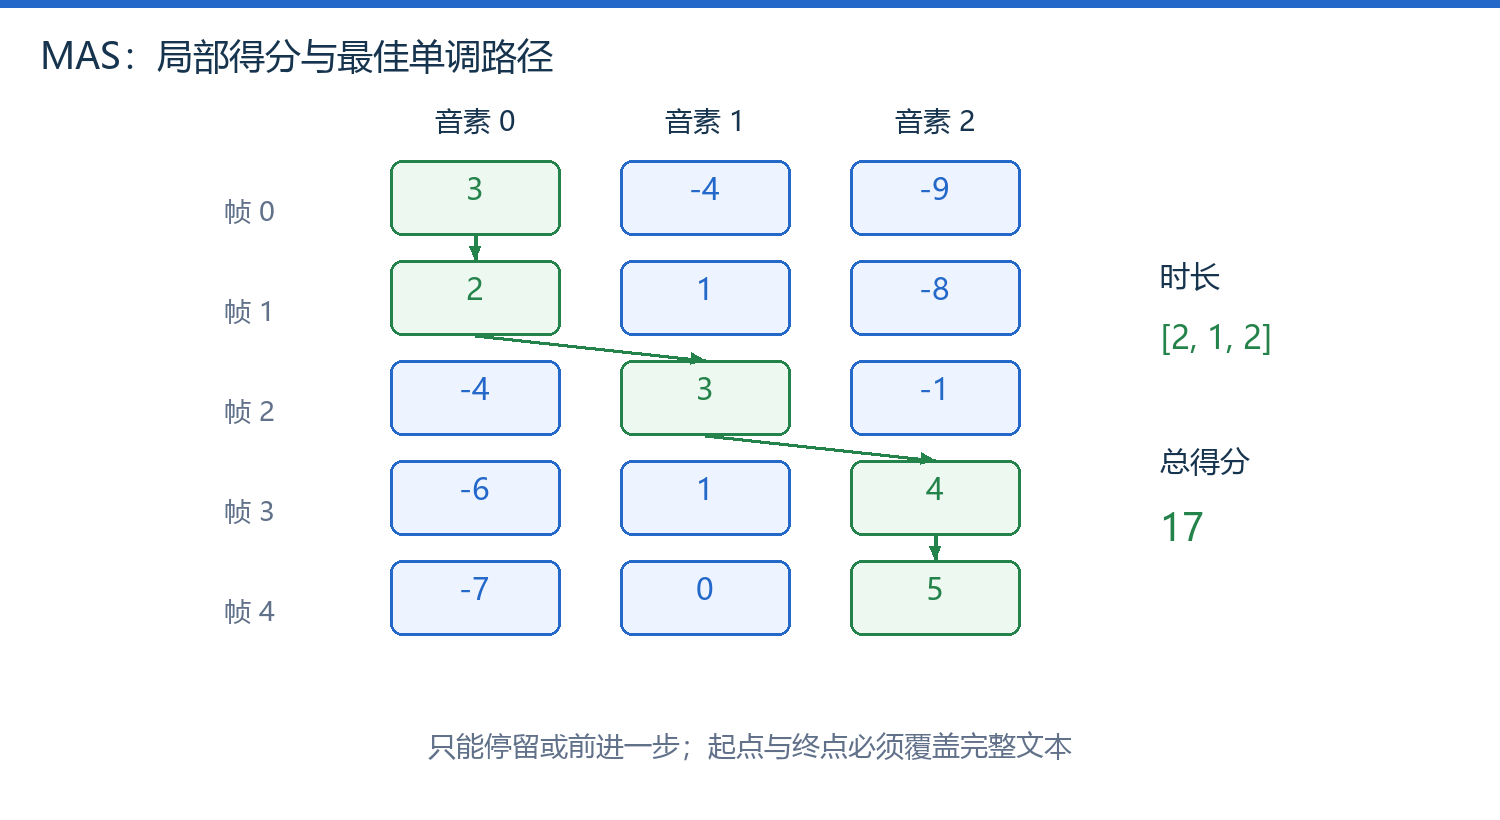
图 2|五帧对三个音素的路径:0、0、1、2、2
| 路径要求 | 原因 |
|---|---|
| 从第一个音素开始 | 防止省略开头 |
| 每帧恰好归属一个音素 | 得到确定的帧级对应关系 |
| 只停留或前进一步 | 保持文本顺序 |
| 最终到达最后一个音素 | 覆盖完整文本 |
路径各列的计数直接形成音素时长,可以监督后续时长预测器。
单调性只约束顺序,不保证每个边界都符合真实发音;录音与文字不匹配仍会污染监督。
3. 与 flow matching 的区别
| 方法 | 关键对象 | 训练核心 | 推理 |
|---|---|---|---|
| Glow-TTS 的 normalizing flow | 显式可逆变换 | 似然与可计算 Jacobian | 反向变换采样 |
| F5-TTS 的 flow matching | 随时间变化的速度场 | 回归速度 | 数值积分 ODE |
两者都叫 flow,却不要求相同的网络结构与训练公式。接着阅读 MAS 动态规划实现与 VITS 的联合建模,再进入 F5-TTS。
专题导航:TTS 总目录
正在连接 GitHub 评论…